Claude Fable 5.2 est le modèle le plus puissant d’Anthropic, sorti le 9 novembre 2026. Il mène seul des chantiers de plusieurs heures, voire de plusieurs jours, en code, en analyse financière et en recherche. Il est inclus dans les abonnements Claude Pro, Max, Ultra, Team et Enterprise, coûte 8 dollars le million de tokens en entrée et 40 en sortie via l’API, et Anthropic conseille de le réserver aux tâches où Opus 5.5 ne suffit pas.
Uber l’a laissé auditer sa sécurité douze heures sans surveillance. Oracle lui confie des requêtes SQL sur lesquelles deux autres modèles se trompaient d’un facteur 5 à 8. Chez AI Sisters, cabinet de conseil en IA, nous avons trié les retours des premières entreprises testeuses pour garder ce qui se transpose chez vous, et vous dire quand Opus 5.5 suffit.
En bref
- Sorti le 9 novembre 2026, Fable 5.2 est le modèle le plus capable d’Anthropic, au-dessus d’Opus 5.5, Sonnet 5.5 et Haiku 5.5.
- Il est fait pour les travaux longs et flous : audit de code, gros dossiers à recouper, modèles financiers, recherche.
- Prix API : 8 dollars en entrée et 40 en sortie par million de tokens, 20 % de moins que Fable 5.1. Réponses jusqu’à 30 % plus rapides.
- Il est disponible dans Claude Pro, Max, Ultra, Team et Enterprise, dans Claude Code, et chez AWS, Google Cloud et Microsoft Azure.
- Claude Mythos 5.2 est le même modèle avec moins de garde-fous en cybersécurité et en biologie. Il est réservé aux organisations vérifiées.
- Pour la plupart des tâches de bureau, Anthropic recommande de commencer par Opus 5.5, puis de passer à Fable si le résultat ne suffit pas.
- Côté données, les échanges avec Fable sont conservés 30 jours par défaut pour la surveillance de sécurité.
7 cas d’usage réels de Claude Fable 5.2 en entreprise
Ces cas viennent des témoignages d’entreprises publiés par Anthropic le 9 novembre. Ce ne sont pas des mesures indépendantes.
1. Finance : des requêtes SQL justes sur des données complexes
Oracle a demandé à Fable 5.2 de croiser des synthèses de dette par pays, des historiques de remboursement et des références régionales. Sa requête SQL a donné les bons résultats. Celles de deux autres modèles additionnaient des montants déjà agrégés, avec des totaux 5 à 8 fois trop élevés.
Chez vous : un contrôleur de gestion qui interroge l’entrepôt de données sans attendre l’équipe data. Vérifiez quand même un total connu avant de diffuser.
2. Analyse financière : un modèle de prévision rempli depuis un rapport annuel
Fundamental Research Labs lui a fait reporter les comptes d’un rapport annuel américain dans un modèle de prévision. Fable 5.2 a déduit des cellules ambiguës l’intention de l’auteur, a remarqué que les chiffres régionaux ne retombaient pas sur le total publié, et a tout rempli juste : 91 % sur leur évaluation, contre 86 % pour le meilleur modèle suivant.
Chez vous : la direction financière ou l’équipe fusions-acquisitions qui reprend les comptes d’une cible dans son propre modèle Excel.
3. Banque et assurance : un dossier de crédit passé au crible
Box l’a testé sur les pièces jointes d’une demande de prêt. Fable 5.2 a signalé que les virements de salaire ne correspondaient pas au solde du relevé bancaire, ce qui permet à l’analyste crédit de savoir quoi vérifier en premier.
Chez vous : la souscription, les contrôles KYC, l’analyse d’un appel d’offres de 300 pages. Le modèle signale les incohérences, l’analyste garde la décision.
4. RH et juridique : une revue de conformité qui dit qui doit agir
Harvey, l’outil d’IA juridique utilisé par de grands cabinets d’avocats, l’a testé sur une revue de conformité I-9, le contrôle du droit au travail aux États-Unis. Fable 5.2 a listé les salariés à traiter en priorité, expliqué comment corriger chaque dossier et indiqué qui devait agir.
Chez vous : la vérification des titres de séjour ou l’audit du registre unique du personnel. Nos usages juridiques de Claude sont détaillés dans notre article sur Claude for Legal.
5. Informatique : un audit de sécurité de 12 heures sans surveillance
Un ingénieur d’Uber a confié à Fable 5.2 un audit de sécurité de 10 à 12 heures. Le modèle a envoyé environ 170 agents relecteurs et rendu un rapport, des correctifs prêts à valider et une proposition de politique de sécurité.
Chez vous : la revue de sécurité d’une application interne avant sa mise en production. Les tests d’intrusion restent bloqués par les garde-fous de Fable et relèvent de Mythos 5.2, réservé aux organisations vérifiées.
6. Développement : des projets de plusieurs semaines bouclés en quelques jours
Chez Vercel, des projets qui traînaient depuis des semaines avec d’autres modèles ont été terminés et validés en quelques jours. Chez Shopify, un ingénieur décrit un modèle à qui l’on donne une idée encore floue et qui, après quelques échanges, mène le travail seul, « comme un ingénieur senior ».
Chez vous : la migration d’une vieille application ou la reprise d’un projet que personne n’ose toucher. Notre formation Claude Code part de vos propres dépôts.
7. Recherche et investissement : un analyste qui dit ce qu’il ne sait pas
Le fonds Balyasny lui a demandé d’enquêter sur la façon dont une entreprise avait testé une nouvelle intégration technique. Fable 5.2 a trouvé les bonnes sources, sans exagérer ce qu’elles prouvaient, et a signalé que la question pouvait induire en erreur. Chez Cognition, il a corrigé sa propre estimation et refusé de donner un chiffre avant de l’avoir mesuré.
Chez vous : une note de veille concurrentielle ou une due diligence, là où un chiffre inventé coûte cher.
Vos équipes utilisent déjà Claude ?
Nos formations partent de vos dossiers réels pour apprendre à choisir le bon modèle et à lui confier des tâches longues.
Formation Claude entrepriseRéserver un appelSystème d’exploitation, Fermat, robots : les démonstrations qui font parler
Elles ne concernent pas directement votre service comptable, mais montrent jusqu’où va l’autonomie du modèle.
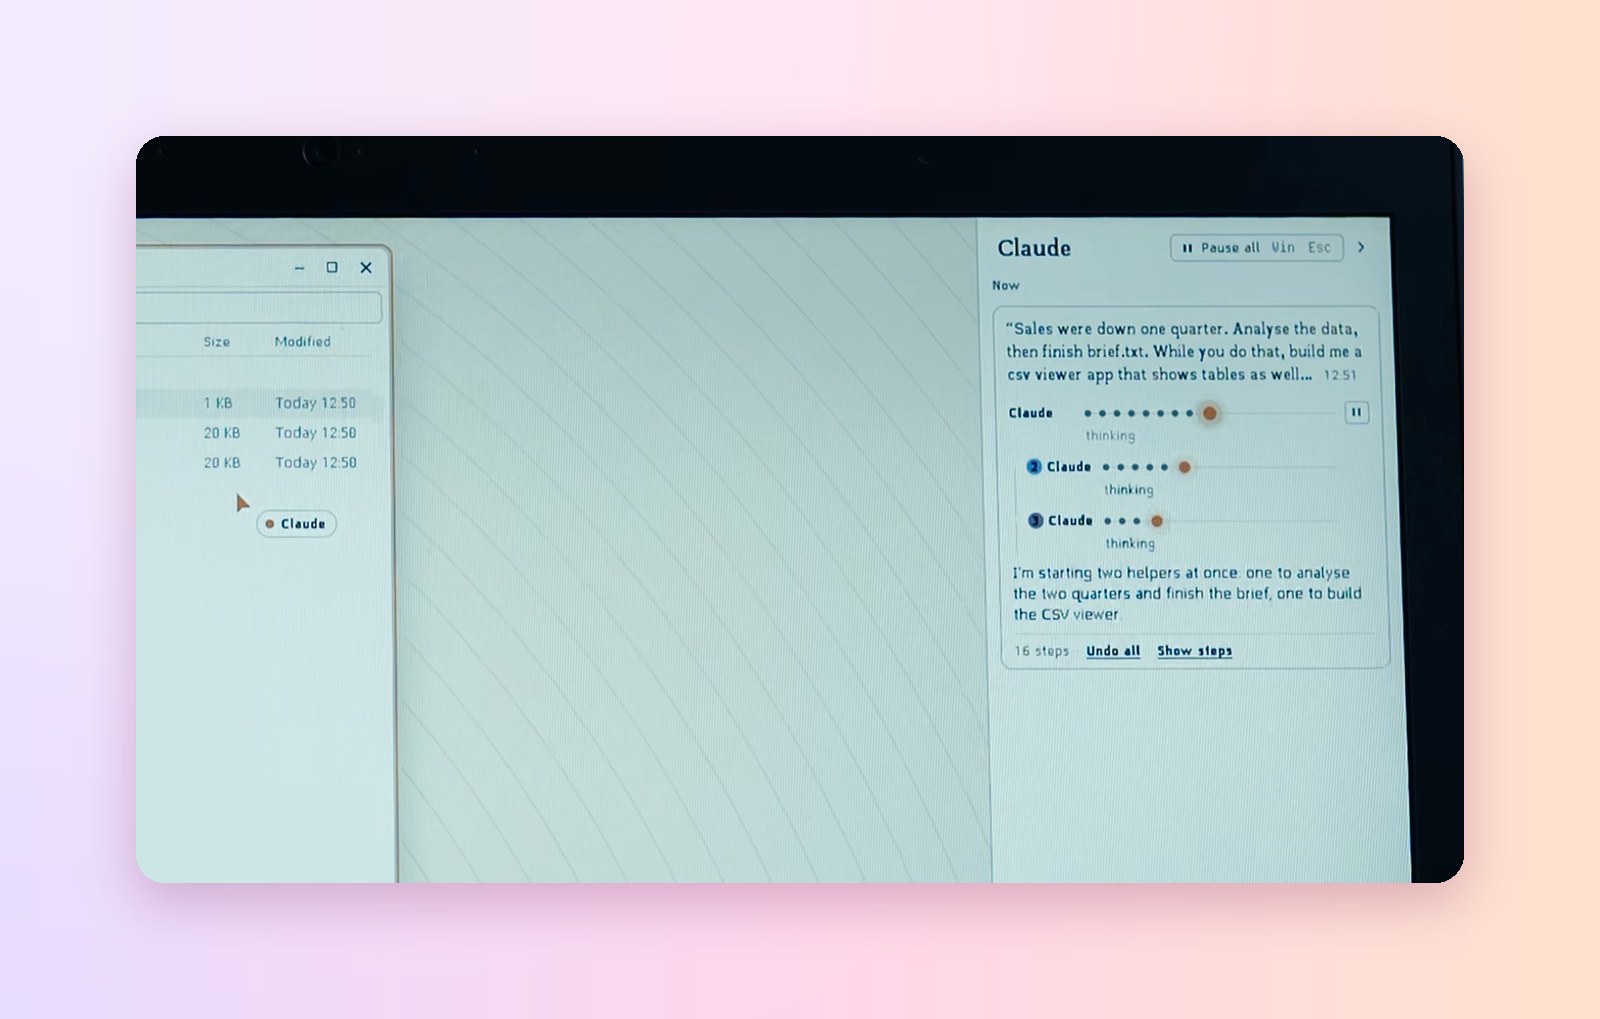
- Fable 5.2 a écrit un système d’exploitation en huit jours. Parti d’un dossier vide, il a coordonné plus de 1 000 sous-agents jour et nuit. Le résultat démarre sur un ordinateur portable, avec fenêtres, écran de connexion et installateur.
- 1 000 agents Fable 5.2 ont formalisé le dernier théorème de Fermat en 30 heures, quand une première version avait demandé 11 jours. Dans les mêmes conditions, Opus 5.5 n’en avait bouclé que 26 % après 18 heures.
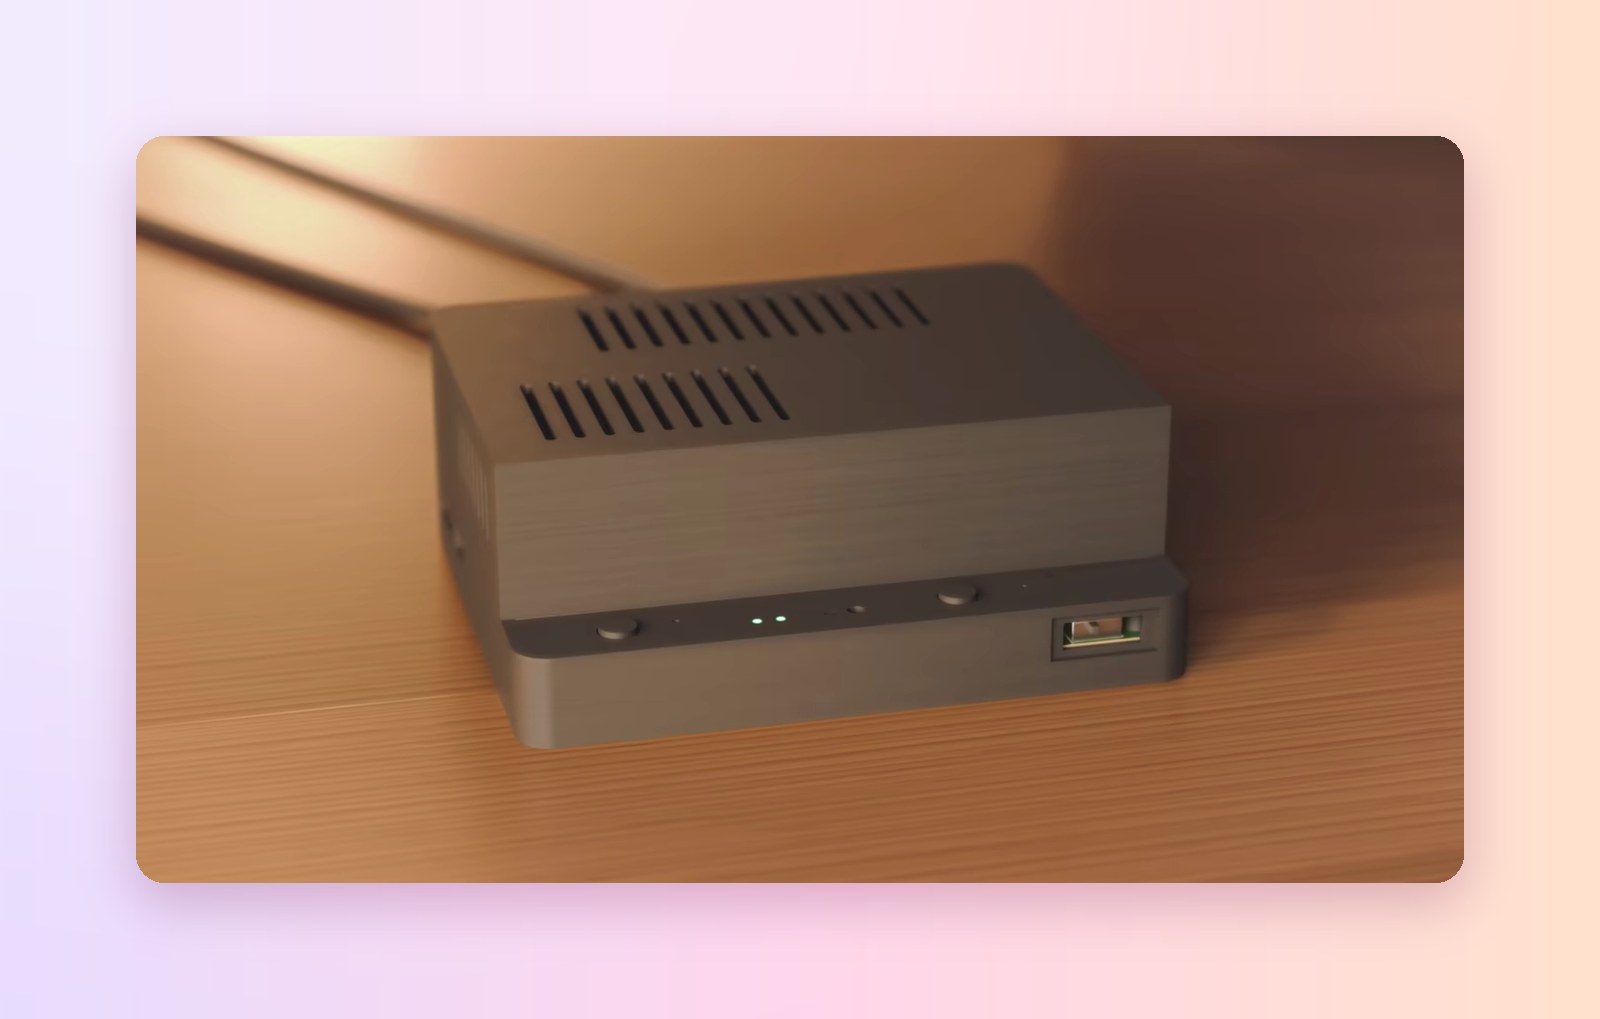
- À partir d’un paragraphe, il a conçu trois appareils électroniques : un hub d’assistant vocal, un haut-parleur USB et un animal virtuel de poche. Les trois ont fonctionné sans retouche électrique, d’après Anthropic et le fabricant Diode.
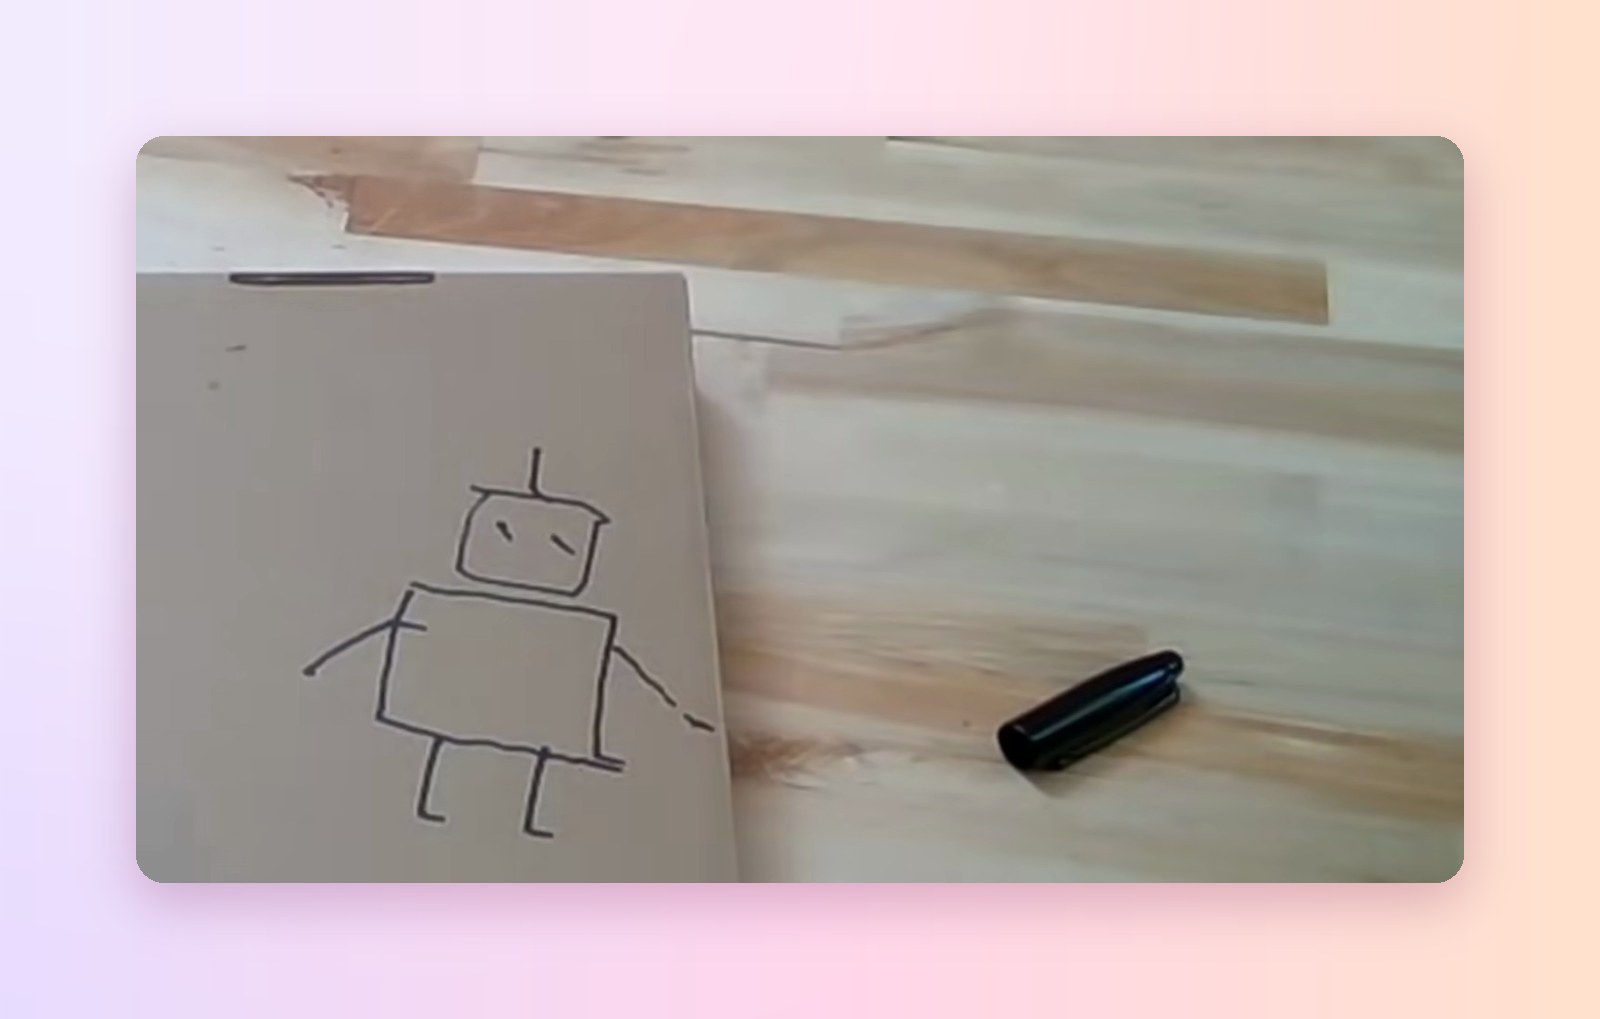
- Il a piloté des robots pour résoudre un casse-tête, dévisser un bouchon ou dessiner. Sur le test RoboDojo, Fable 5.2 atteint 64,9 % de réussite, plus du double de GPT-6 Astra (29,8 %), selon des mesures internes d’Anthropic.
Pour comprendre. Un sous-agent, c’est un collègue à qui le modèle délègue une partie du travail. Fable 5.2 joue le chef de projet : il découpe, distribue, relit et recolle les morceaux.
Fable 5.2 ou Opus 5.5 : lequel choisir pour vos équipes ?
Anthropic le dit lui-même : pour la plupart des tâches de code et de bureautique, commencez par Opus 5.5, son modèle du quotidien. Montez vers Fable 5.2 quand la tâche est longue, ambiguë, ou quand Opus échoue. Descendez vers Sonnet 5.5 ou Haiku 5.5 pour les tâches simples et répétitives.
| Votre besoin | Modèle conseillé | Pourquoi |
|---|---|---|
| Rédiger un e-mail, résumer une réunion, reformuler une note | Sonnet 5.5 ou Opus 5.5 | Rapide, moins cher, largement suffisant |
| Analyser un fichier Excel, préparer une présentation, écrire du code courant | Opus 5.5 | Le modèle recommandé par défaut |
| Recouper un gros dossier (data room, appel d’offres, contrats) pour y trouver les incohérences | Fable 5.2 | Meilleur jugement sur les documents ambigus |
| Audit de code, migration, développement sur plusieurs jours | Fable 5.2 | Tient la durée et coordonne des centaines d’agents |
| Modèle financier, requêtes SQL sur des données complexes | Fable 5.2 | Moins d’erreurs de calcul, d’après Oracle et Fundamental Research Labs |
| Tests d’intrusion, recherche en biologie | Mythos 5.2, sur dossier | Bloqué par les garde-fous de Fable |
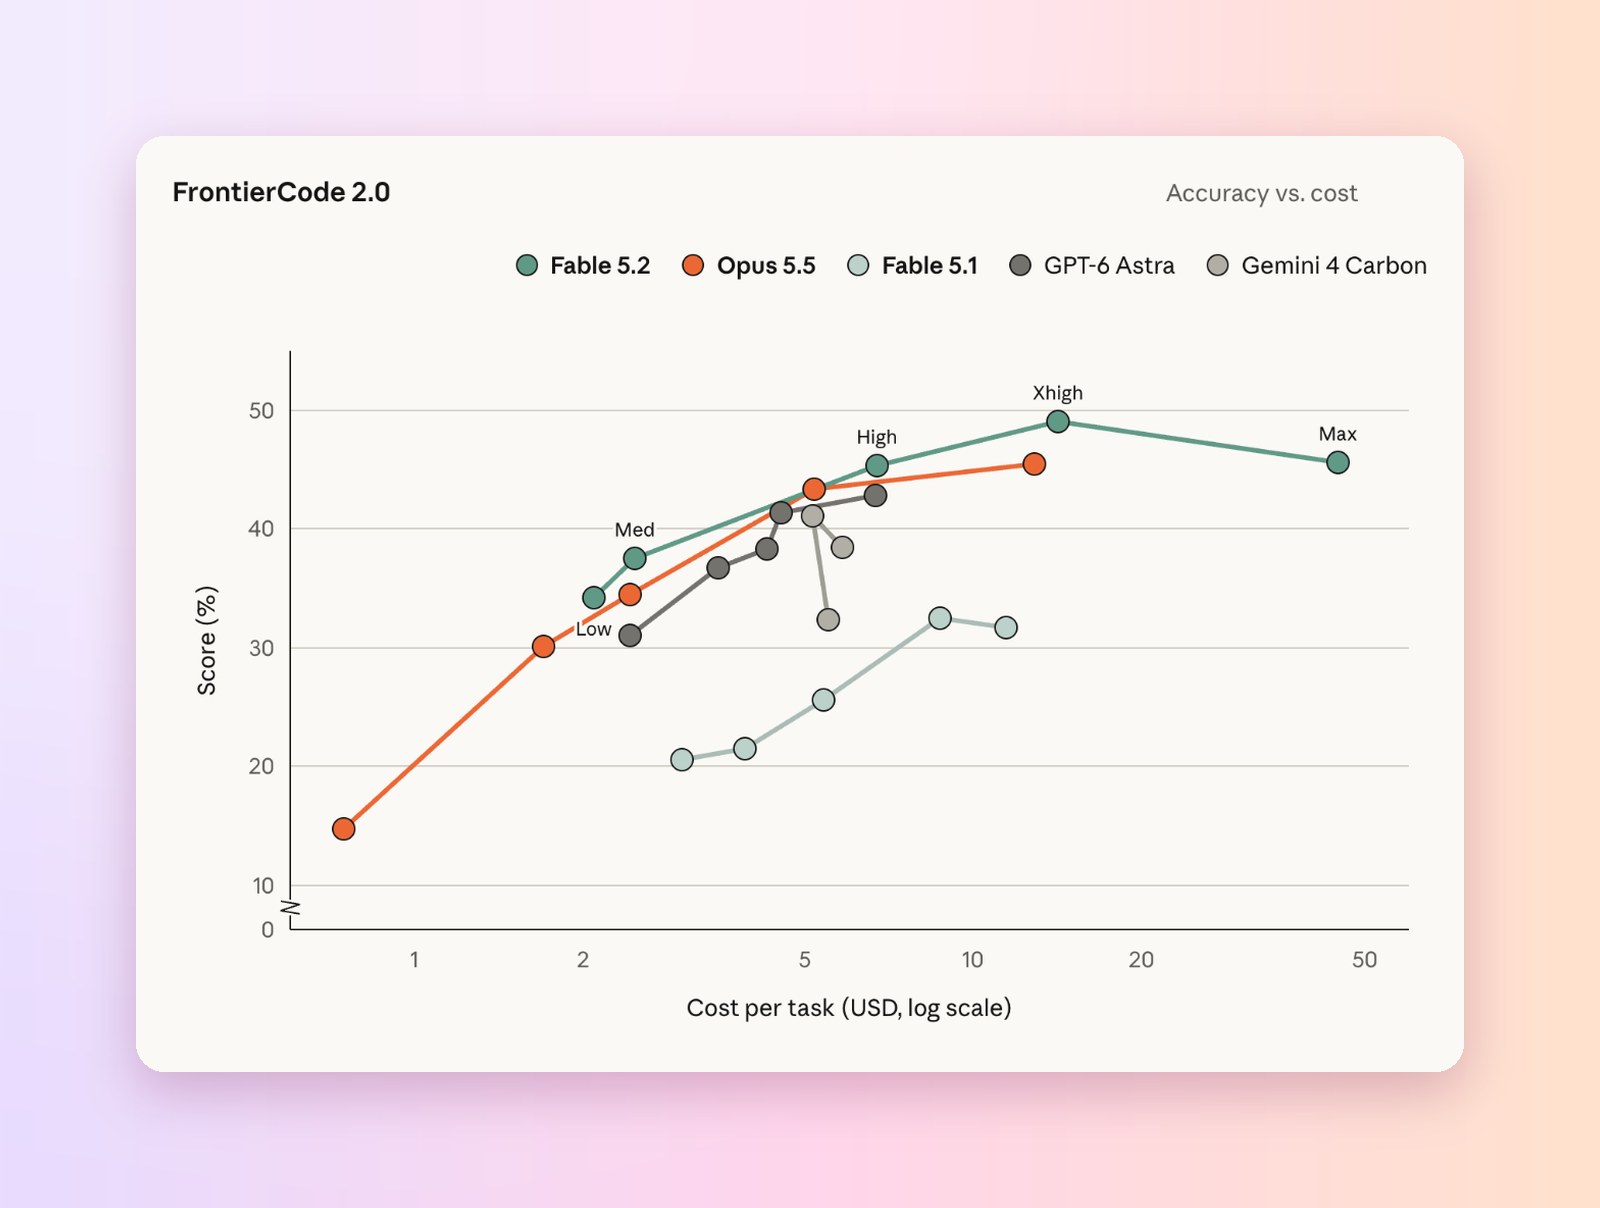
Fable coûte plus cher au token qu’Opus, mais la facture par tâche peut baisser. Sur le test de code FrontierCode 2.0, Fable 5.2 en effort élevé obtient 45,3 %, autant qu’Opus 5.5 à son maximum (45,5 %), pour environ deux fois moins cher par tâche, selon Anthropic.
Pour comprendre. Le niveau d’effort, c’est le temps de réflexion que vous accordez au modèle. « Medium », le réglage par défaut dans Claude, répond vite ; « High » ou « Xhigh » le laisse vérifier davantage. Plus d’effort consomme plus, sans garantie de mieux : au niveau maximal, Fable 5.2 fait moins bien qu’en Xhigh sur ce test.
Vidéo officielle d’Anthropic, en anglais (3 min 28) : quand partir d’Opus 5.5, quand passer à Fable 5.2.
Les chiffres, et qui les a mesurés
| Test | Ce qu’il mesure | Fable 5.2 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| AutomationBench | Processus métier automatisés | 51,4 % | 42,5 % | 41,4 % | 53,9 % |
| AA-Briefcase v1.1 | Travail de bureau, noté sur grille | 66,1 % | 61,2 % | 52,0 % | 61,8 % |
| Remote Labor Index | Missions réelles de freelances | 41,3 % | 21,3 % | 20,8 % | n.c. |
| FrontierSWE v2 | Développement logiciel | 69,9 % | 62,3 % | 65,5 % | 61,2 % |
| Chartography | Lecture de graphiques, sans outil | 73,4 % | 64,4 % | 71,0 % | 72,5 % |
| OSWorld 2.1 | Utilisation d’un ordinateur | 89,3 % | 87,2 % | 79,5 % | 81,5 % |
Ces scores sont mesurés par Anthropic. Fable 5.2 n’est pas premier partout : Gemini 4 Carbon fait mieux sur les processus métier automatisés, et le classement Elo d’AA-Briefcase place Opus 5.5 légèrement devant.
Côté indépendant, Artificial Analysis place Fable 5.2 en tête de son indice d’intelligence avec 65 points, cinq de plus que Gemini 4 Carbon et six de plus qu’Opus 5.5, d’après OfficeChai.
Prix, abonnements et données : ce qu’il faut savoir avant de l’activer
- Fable 5.2 est inclus dans Claude Pro, Max, Ultra, Team et Enterprise. Sur Pro et les sièges Team standard, il peut représenter jusqu’à 50 % des limites hebdomadaires.
- Via l’API, il coûte 8 dollars en entrée et 40 en sortie par million de tokens, contre 10 et 50 pour Fable 5.1. Le mode rapide, jusqu’à 2,5 fois plus véloce, coûte 16 et 80 dollars.
- Les demandes sensibles en cybersécurité ou en biologie sont redirigées automatiquement vers un modèle moins puissant (Opus 4.8 ou Opus 5).
- Utiliser Fable implique par défaut une conservation de 30 jours pour la surveillance de sécurité. Les clients Enterprise éligibles peuvent rester en conservation zéro. À valider avec votre DPO.
Pour comprendre. Le prix au million de tokens, c’est le prix au litre. La facture, c’est ce que vous consommez. Un modèle plus cher au litre qui arrive à destination sans détour peut coûter moins cher à l’arrivée.
Par où commencer : tester Fable 5.2 en 4 étapes
- Choisissez une tâche qui a déjà résisté à Opus 5.5 : un dossier de 200 pages à recouper, un reporting dont les totaux ne tombent pas juste, un bug introuvable.
- Dans Claude, ouvrez le sélecteur de modèle de la zone de saisie et choisissez Fable 5.2. Dans Claude Code, tapez /model.
- Donnez tout le contexte et le résultat attendu, puis laissez-le travailler. Demandez-lui de lister ce qu’il n’a pas pu vérifier.
- Lancez la même demande sur Opus 5.5 et comparez la qualité, le temps passé et la part de votre quota consommée. Gardez Fable pour les tâches où l’écart est net.
Où Fable 5.2 ferait-il gagner du temps à vos équipes ?
Un échange de 30 minutes pour repérer les tâches où Fable, Opus ou Sonnet font vraiment la différence chez vous.
Réserver un appelFormation Claude entrepriseÀ lire aussi : Claude en entreprise, le guide pour vos équipes, Claude, ChatGPT ou Gemini : quelle IA choisir et Claude et Pennylane pour les équipes finance.
À retenir
- Claude Fable 5.2, sorti le 9 novembre 2026, est le modèle le plus puissant d’Anthropic, inclus dans les offres Pro, Max, Ultra, Team et Enterprise.
- Ses meilleurs usages en entreprise : gros dossiers à recouper, modèles financiers, requêtes SQL complexes, audits et projets de développement longs.
- Pour le quotidien, Opus 5.5 reste le point de départ conseillé par Anthropic.
- Les conversations sont conservées 30 jours par défaut : validez l’usage avec votre DPO.
Sources
- Anthropic, Introducing Claude Fable 5.2 and Claude Mythos 5.2, 9 novembre 2026, mis à jour le 11 novembre.
- Anthropic, Claude Fable 5.2, page produit (prix, disponibilité, conservation des données), consulté le 12 novembre 2026.
- Claude sur YouTube, Fable 5.2 or Opus? When to use each model in Claude Code, 11 novembre 2026.
- CNBC, Anthropic releases Claude Fable 5.2 and Claude Mythos 5.2 ahead of IPO, 9 novembre 2026.
- OfficeChai, Anthropic Jumps To Top Of Artificial Analysis Intelligence Index With Fable 5.2, novembre 2026.
- KultureGeek, Claude Fable 5.2 et Mythos 5.2 disponibles : les IA d’Anthropic s’améliorent, 9 novembre 2026.