Derrière Jev, il y a la startup TypeSafe AI, sortie de l’ombre à la mi-septembre 2026 avec 40 millions de dollars levés. Son fondateur, Diogo Almeida, a passé quatre ans chez OpenAI et cosigné l’article de recherche qui a mené à ChatGPT.
Depuis deux semaines, une nouvelle IA fait beaucoup parler d’elle. Elle s’appelle Jev, et elle ne rédige rien. 😅
Pas de paragraphe, pas de résumé, pas de mail. Elle répond « oui », « non », « urgent », « à relancer », et elle ajoute son niveau de confiance.
Son éditeur annonce des prix qui donnent le vertige. Et plusieurs grandes plateformes du web l’ont branchée en trois jours.
On a lu les tests, y compris ceux qui dérangent. Voici ce que ça vaut pour vos équipes 👇
« Les LLM produisent des mots pour les humains. Jev produit des décisions typées, plus proches du code : fiables, rapides, cohérentes », écrit TypeSafe AI sur son site (traduit de l’anglais).
En bref
- Jev ne génère pas de texte, il décide. Il renvoie une étiquette et un score de confiance, jamais un paragraphe.
- Il est fait pour le travail de tri : e-mails, commentaires, tickets, documents, en gros volume.
- Sur ces tâches, il est très rapide et très peu cher, d’après les mesures de son éditeur.
- Aucun organisme indépendant ne l’a évalué, et TypeSafe refuse les classements publics, par principe.
- Le même test public passe de 63 à 95 % de bonnes réponses selon la façon de découper les questions.
- Le service est hébergé aux États-Unis, sans région européenne. À regarder avant d’y envoyer des données personnelles.
À lire également
Découvrez nos autres articles pour aller plus loin sur l’IA en entreprise :
Jev, l’IA qui décide au lieu d’écrire
Imaginez deux collègues devant la même pile de dossiers.
Le premier lit chaque dossier et vous rédige une note. C’est ce que font ChatGPT, Claude ou Gemini.
Le second ne rédige rien. Il pose une étiquette sur chaque dossier : urgent, à facturer, à ignorer. Et il vous dit à quel point il est sûr de lui.
Le second, c’est Jev.
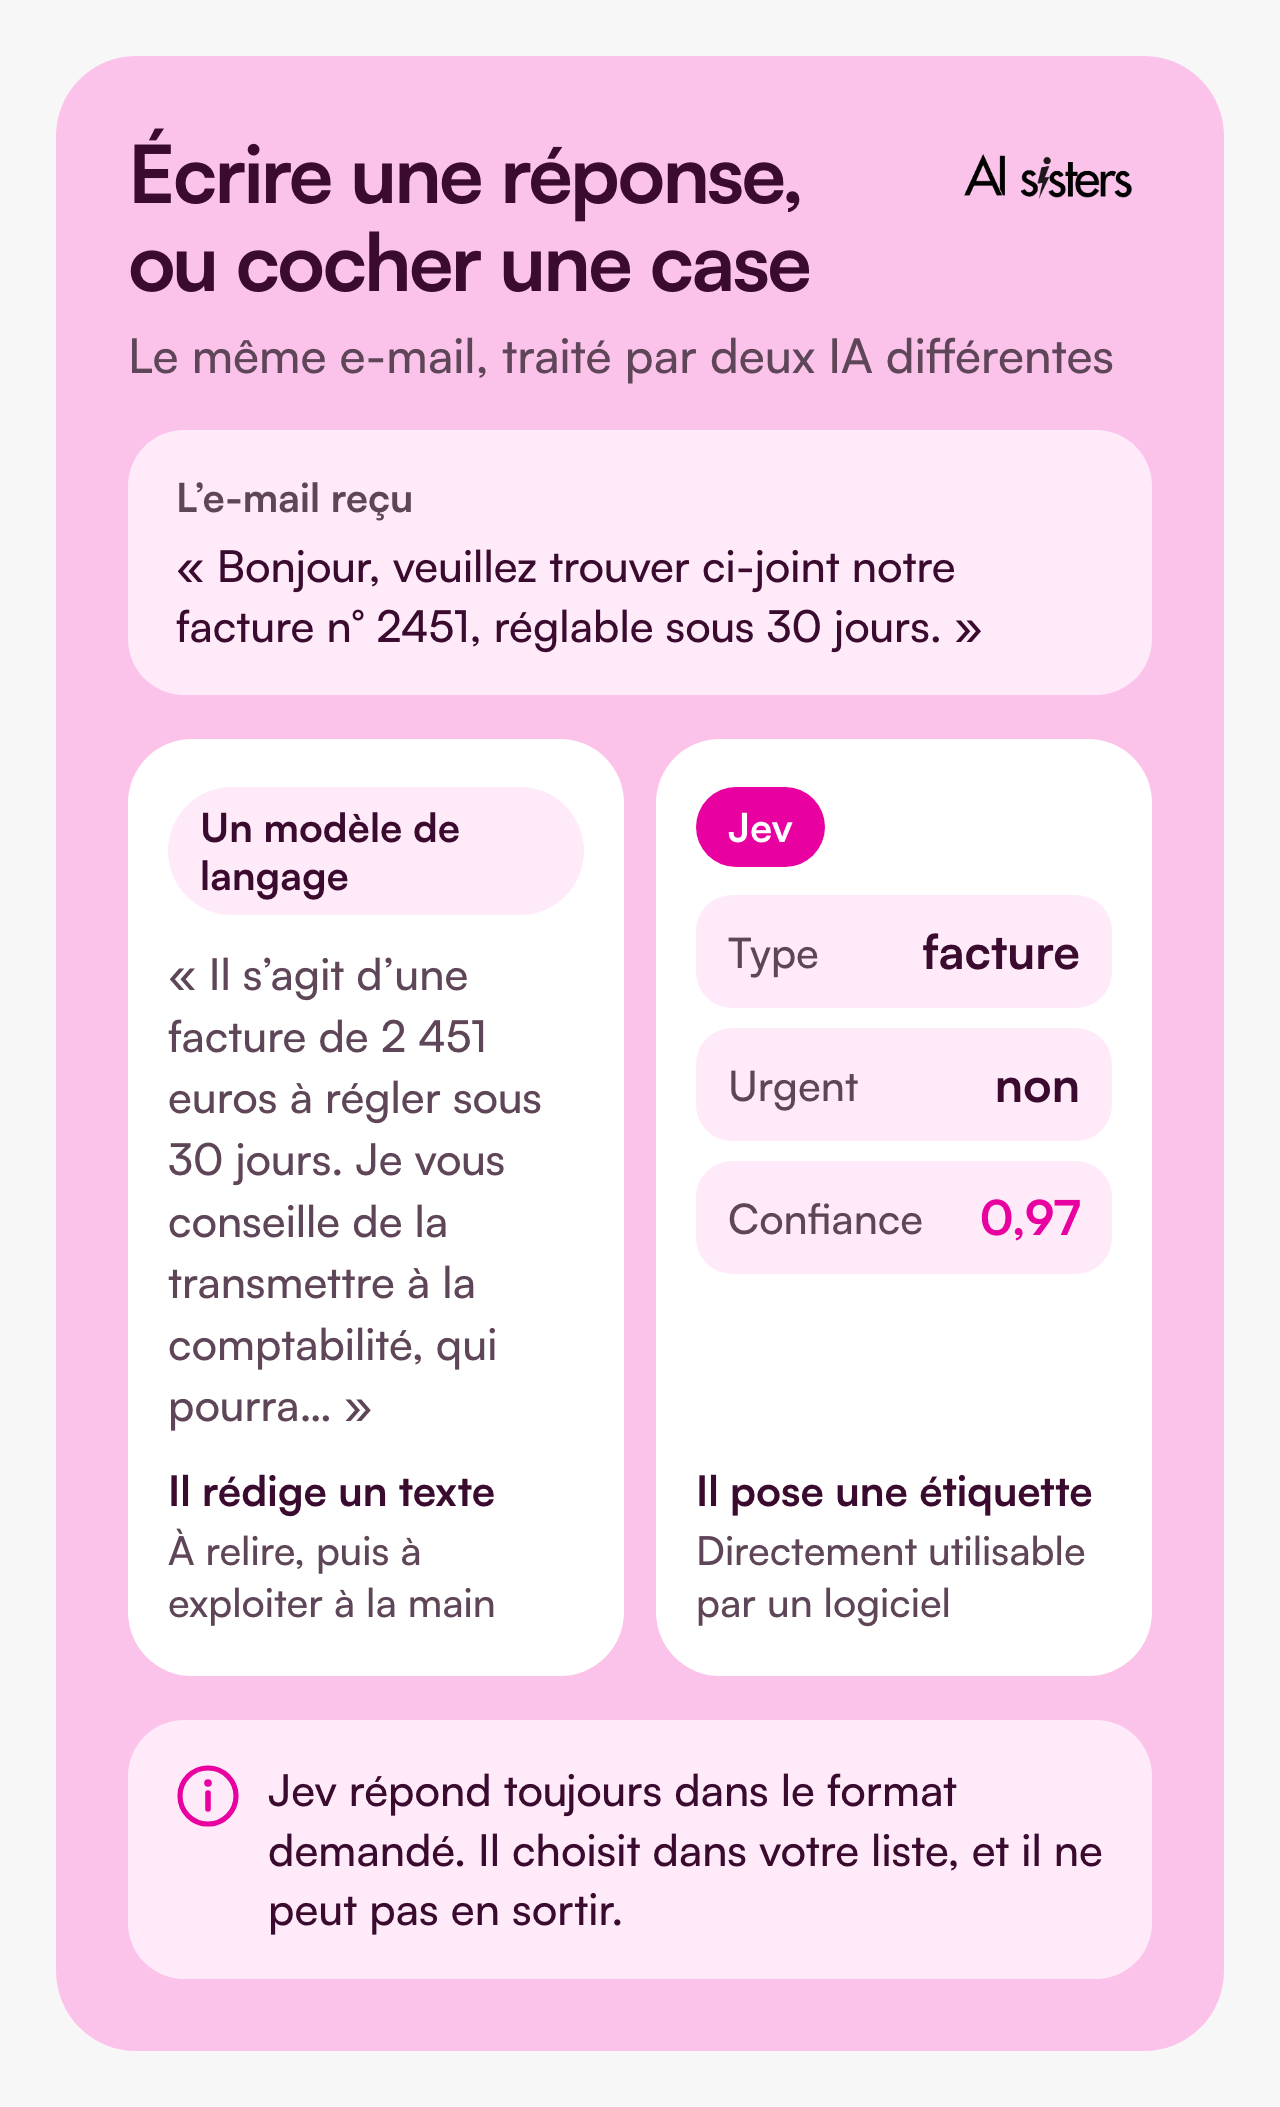
Vous lui donnez un texte et une question fermée. Il répond par un choix, une note ou une probabilité, toujours dans le format demandé. Vous pouvez poser vingt questions d’un coup, ça ne change presque rien au temps de réponse.
💡 Pour comprendre : un modèle de langage écrit une réponse, Jev coche une case.
Petit clin d’œil au passage : le modèle porte le nom de l’économiste William Stanley Jevons, celui qui a montré qu’une machine plus économe finit par faire exploser la consommation.
L’adoption a suivi très vite côté outils. Vercel, Cloudflare, LangChain et Langfuse l’ont intégré en trois jours.
Jev en entreprise : les cas d’usage qui reviennent
Les premiers essais publiés dessinent toujours la même famille de tâches. Du tri, en gros volume, avec des règles simples.
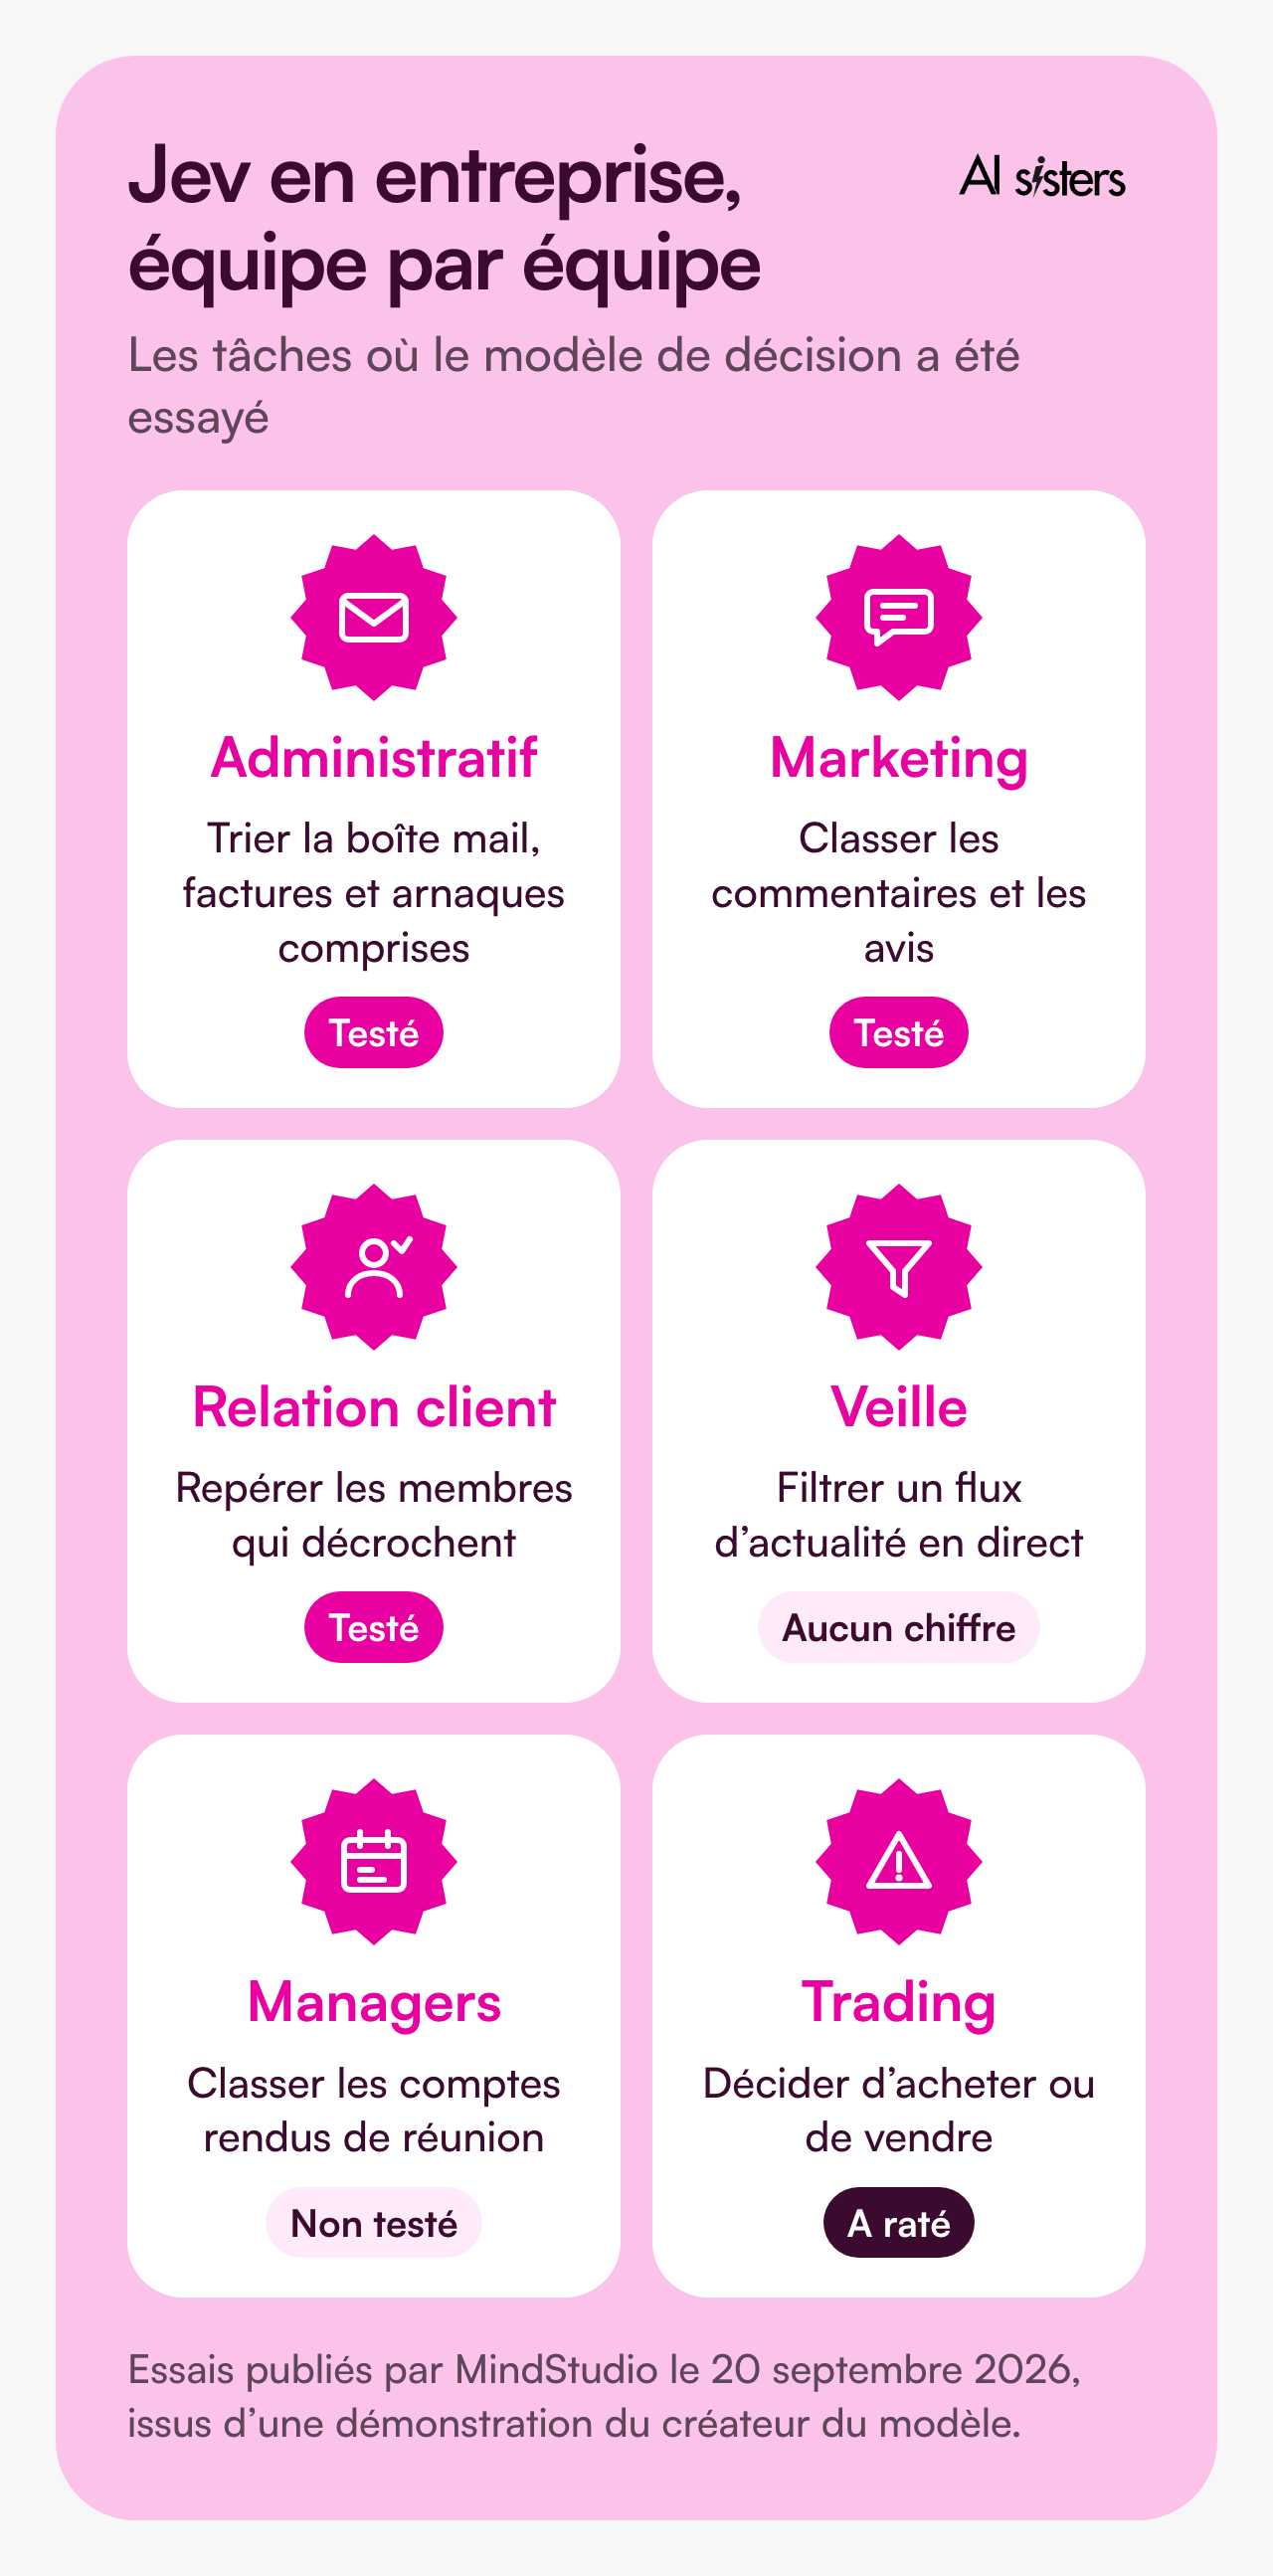
Pour une équipe administrative : trier la boîte mail.
Dans la démonstration la plus commentée, 1 000 e-mails passent au crible de sept règles à la fois, dont la détection des factures et celle des arnaques. Le tout en quelques secondes, pour quelques centimes.
Pour une équipe marketing : trier les commentaires et les avis.
Même principe sur 1 000 commentaires, classés par type, par sentiment, et selon qu’ils méritent une réponse.
Pour une équipe relation client : repérer les clients qui décrochent.
Sur les messages d’une communauté, les étiquettes portent sur le risque de départ, le niveau du membre et la force du témoignage. De quoi remonter les bons verbatims sans tout relire.
Pour une équipe veille : filtrer un flux d’actualité en direct, entre information utile et bruit.
Sur ce cas, aucun chiffre n’est donné.
Pour les managers : classer les comptes rendus de réunion.
Type de réunion, décision prise ou pas, action attribuée à quelqu’un ou pas. Attention, ce cas n’a pas été testé, il est seulement décrit.
Et un cas qui rate, tout aussi instructif : un robot de trading qui rejouait une décision par seconde. Son auteur reconnaît qu’il se comportait mal dès la première heure. Aller vite ne veut pas dire viser juste.
Ces chiffres viennent d’une démonstration du créateur du modèle, reprise par une plateforme qui vend de l’accès aux IA. Personne d’extérieur ne les a rejoués.
C’est exactement ce qu’on voit en formation : les équipes avancent quand elles choisissent la tâche avant l’outil 💡 C’est tout le principe de notre approche de la formation par métier.
Découvrez nos formations IA & réservez un appel
Explorez nos différents modules de formation et choisissez, avec nous, celui qui répondra le mieux à vos besoins en IA.
📚 Voir nos formations IA 📞 Réserver un appel découverte
Les chiffres de Jev : ce qui est mesuré, ce qui ne l’est pas
TypeSafe annonce jusqu’à 193 fois plus rapide et 444 fois moins cher que les grands modèles.
Le chiffre est spectaculaire. Sa méthode l’est moins.
Pour savoir si Jev répond juste, l’éditeur compare ses réponses à la moyenne de celles de deux grands modèles concurrents. Il mesure donc si Jev est d’accord avec eux, pas s’il a raison.
Et il l’écrit lui-même, noir sur blanc : ces gains sont dans le haut de la fourchette, et les tests ont été conçus par son équipe. Ce niveau d’aveu est rare, il faut le lui reconnaître.
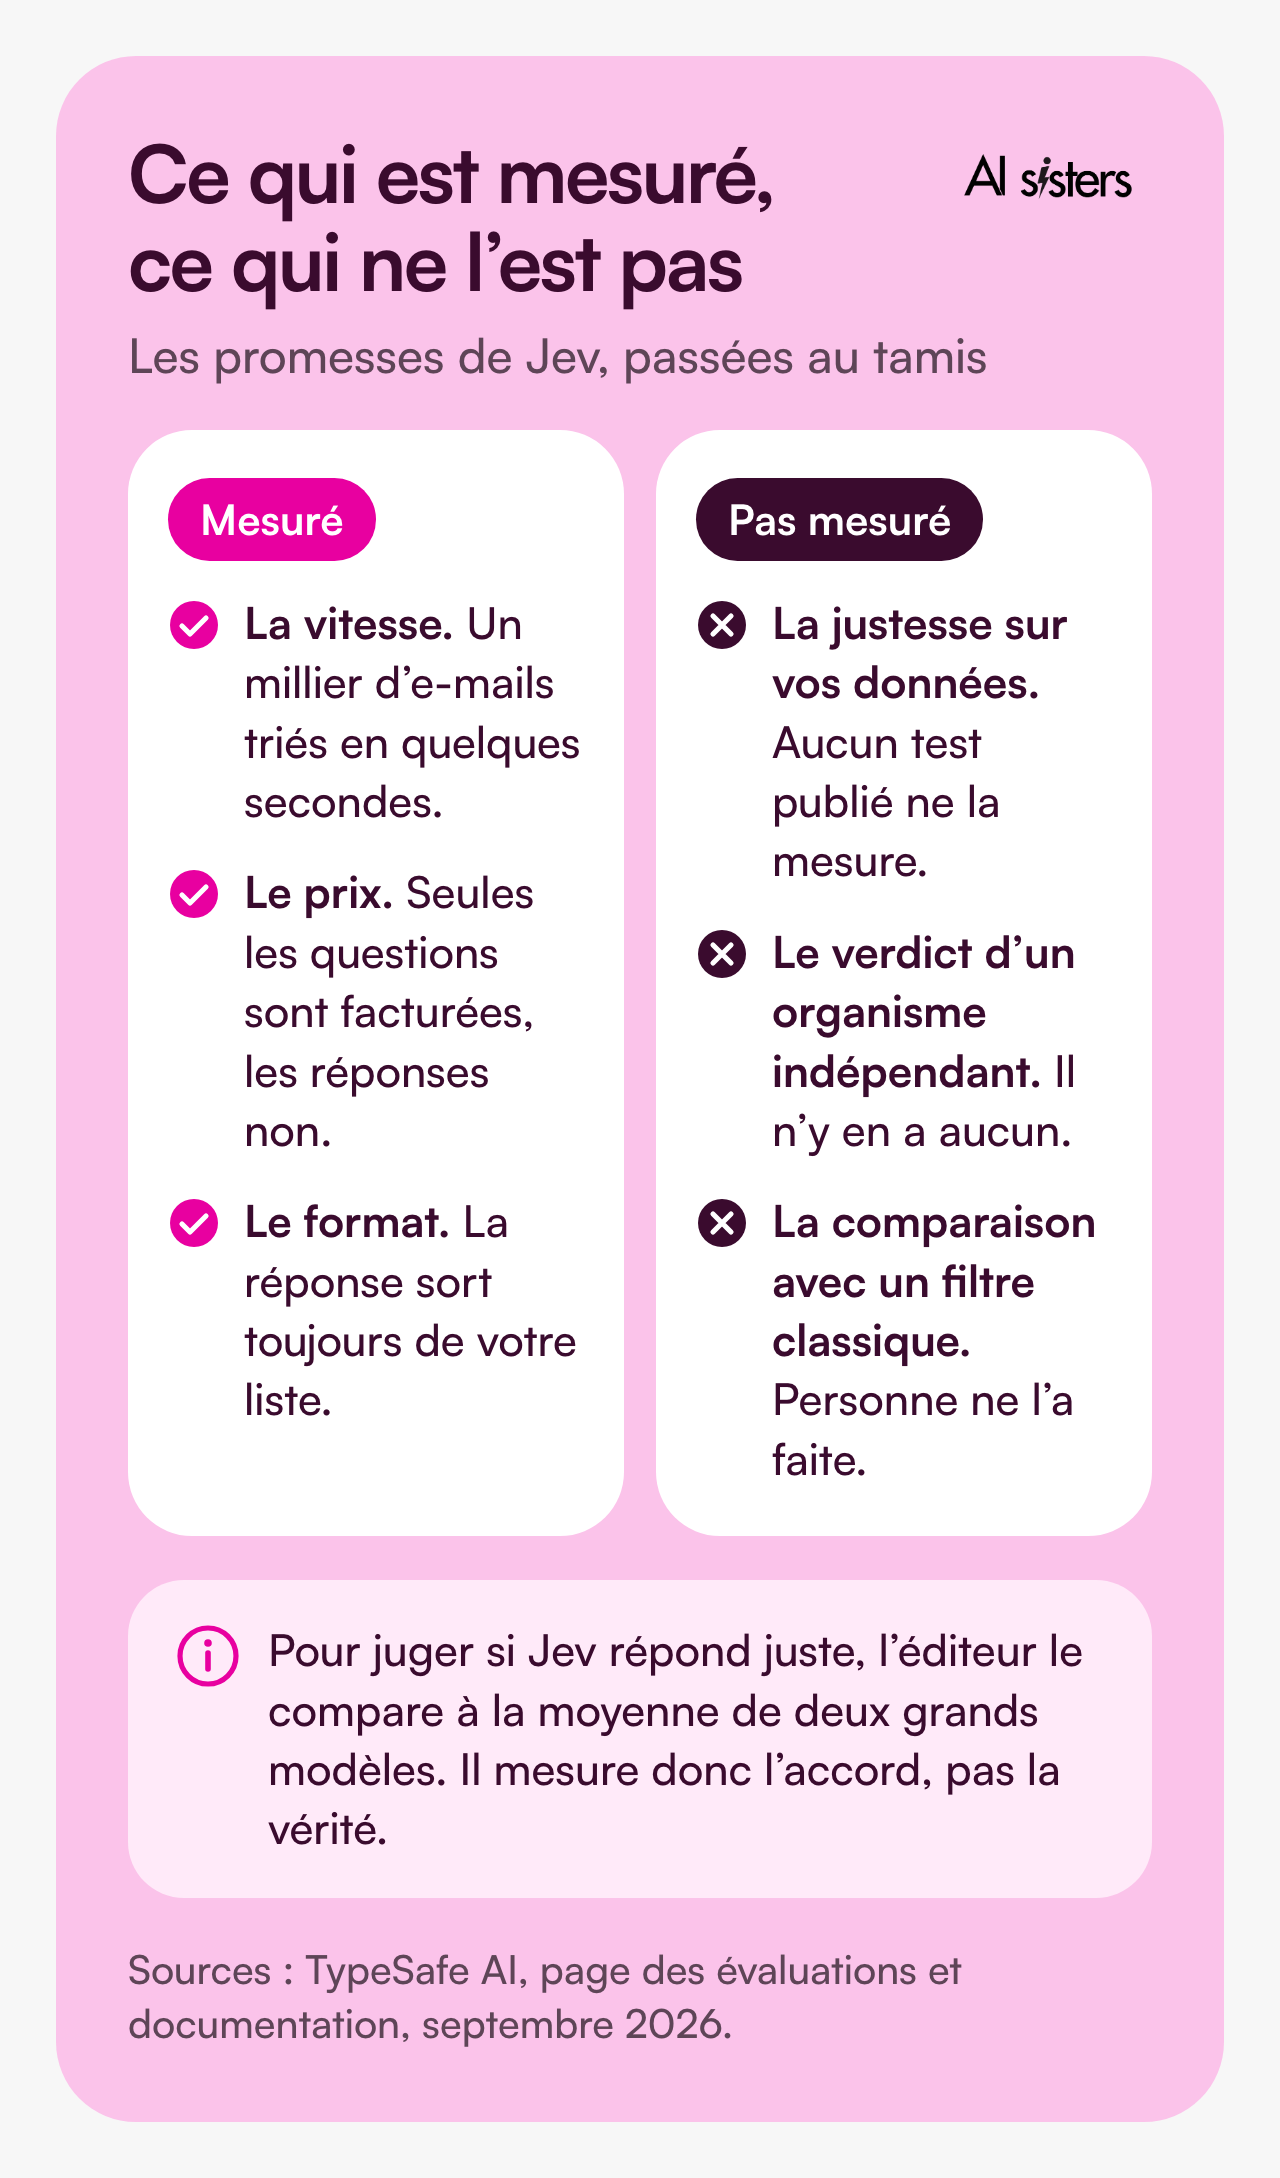
Même chose pour le fameux zéro hallucination. Jev ne peut pas inventer une catégorie absente de votre liste. Mais il peut choisir la mauvaise, et l’éditeur le dit sur son site.
Le prix, lui, se vérifie de l’extérieur. Les plateformes qui revendent l’accès affichent le même tarif : seules les questions sont facturées, les réponses ne le sont pas.
L’ordre de grandeur se calcule à partir des tarifs publics : analyser le même texte revient plus de deux cents fois moins cher avec Jev qu’avec un grand modèle. En échange, vous n’avez pas de réponse rédigée, juste une étiquette.
Côté justesse, deux évaluations indépendantes existent, publiées par des particuliers avec leurs données brutes. Ni Artificial Analysis, ni ARC Prize, ni aucun organisme reconnu n’a testé Jev.
La première lui donne 96 % de bonnes réponses sur un test de tri, loin devant une liste de mots-clés écrite à la main.
La seconde, sur 2 000 e-mails de phishing, est nettement plus sévère. Posé en une seule question, Jev fait moins bien qu’un simple filtre de motifs. Découpé en cinq questions simples, il repasse devant tout le monde.
Ce que ça dit surtout : la façon de poser la question fait la moitié du résultat.
💡 En clair : la vitesse et le prix sont crédibles. La justesse, elle, se vérifie chez vous, sur vos données.
Jev ou votre IA actuelle : comment choisir
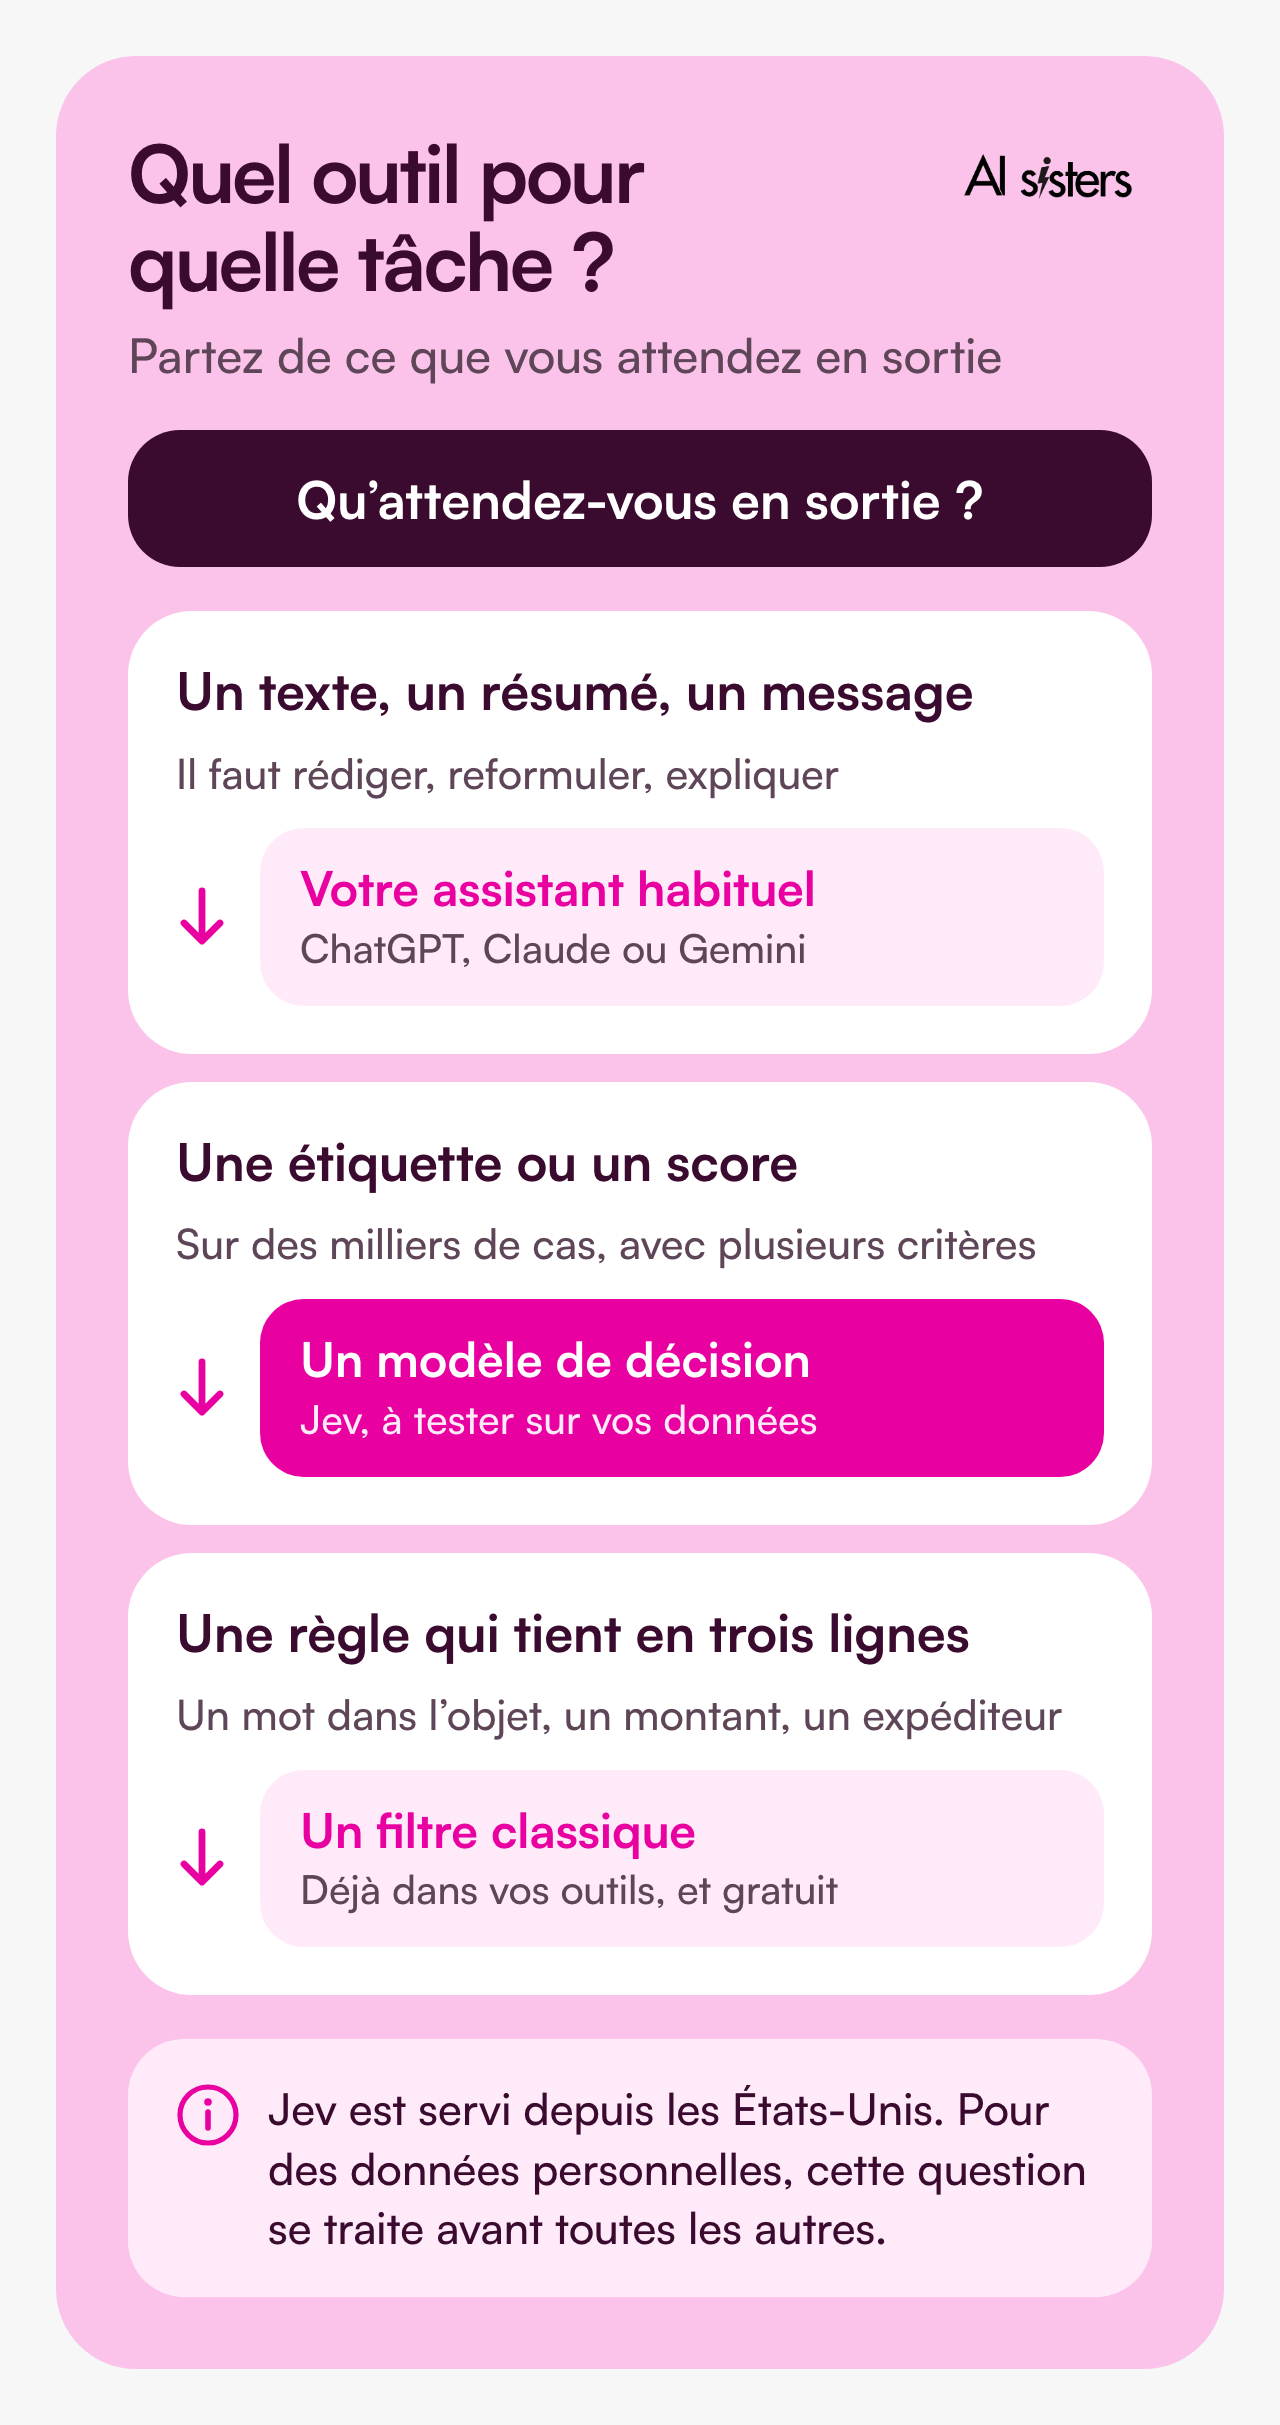
Personne ne vous demande de résilier votre abonnement. La question est de savoir quelle tâche mérite quel outil.
Si la sortie attendue est un texte, un résumé, un message ou une analyse : gardez votre assistant habituel.
Si la sortie attendue est une étiquette ou un score, sur des milliers de cas : un modèle de décision devient intéressant.
Et si votre règle tient en trois lignes, un filtre classique fera le travail pour rien. C’est la comparaison que personne n’a faite, et elle vaut dix minutes de votre temps.
Restent cinq limites à connaître.
🚨 Jev ne prend pas le temps de réfléchir. Un analyste le résume bien : il n’a pas de processus qui fait mûrir un problème.
🚨 Sur le même document, il ne redonne pas forcément la réponse au mot près. L’éditeur revendique la cohérence, pas la reproductibilité.
🚨 Un garde-fou de sécurité ne peut pas reposer sur lui seul. Un test montre qu’un texte malveillant glissé dans un document fait basculer sa décision.
🚨 Il ne compte pas de façon fiable, son éditeur le dit lui-même. Pour additionner des montants, ce n’est pas le bon outil. Et il traite un document à la fois, pas votre base documentaire entière.
🚨 Le service est servi depuis les États-Unis, sans région européenne documentée. La conformité passe par des clauses contractuelles, pas par un hébergement local. Pour des données personnelles, cette question se traite avant toutes les autres.
Réservez dès maintenant votre appel de 30 minutes
Un échange sans engagement pour construire votre formation IA autour de vos outils.
👉 Parlez-nous de votre projet IA 👈
Tester Jev sans y laisser la semaine
Vous voulez savoir si ça marche chez vous. Le protocole le plus court qui donne une réponse honnête tient en cinq étapes.
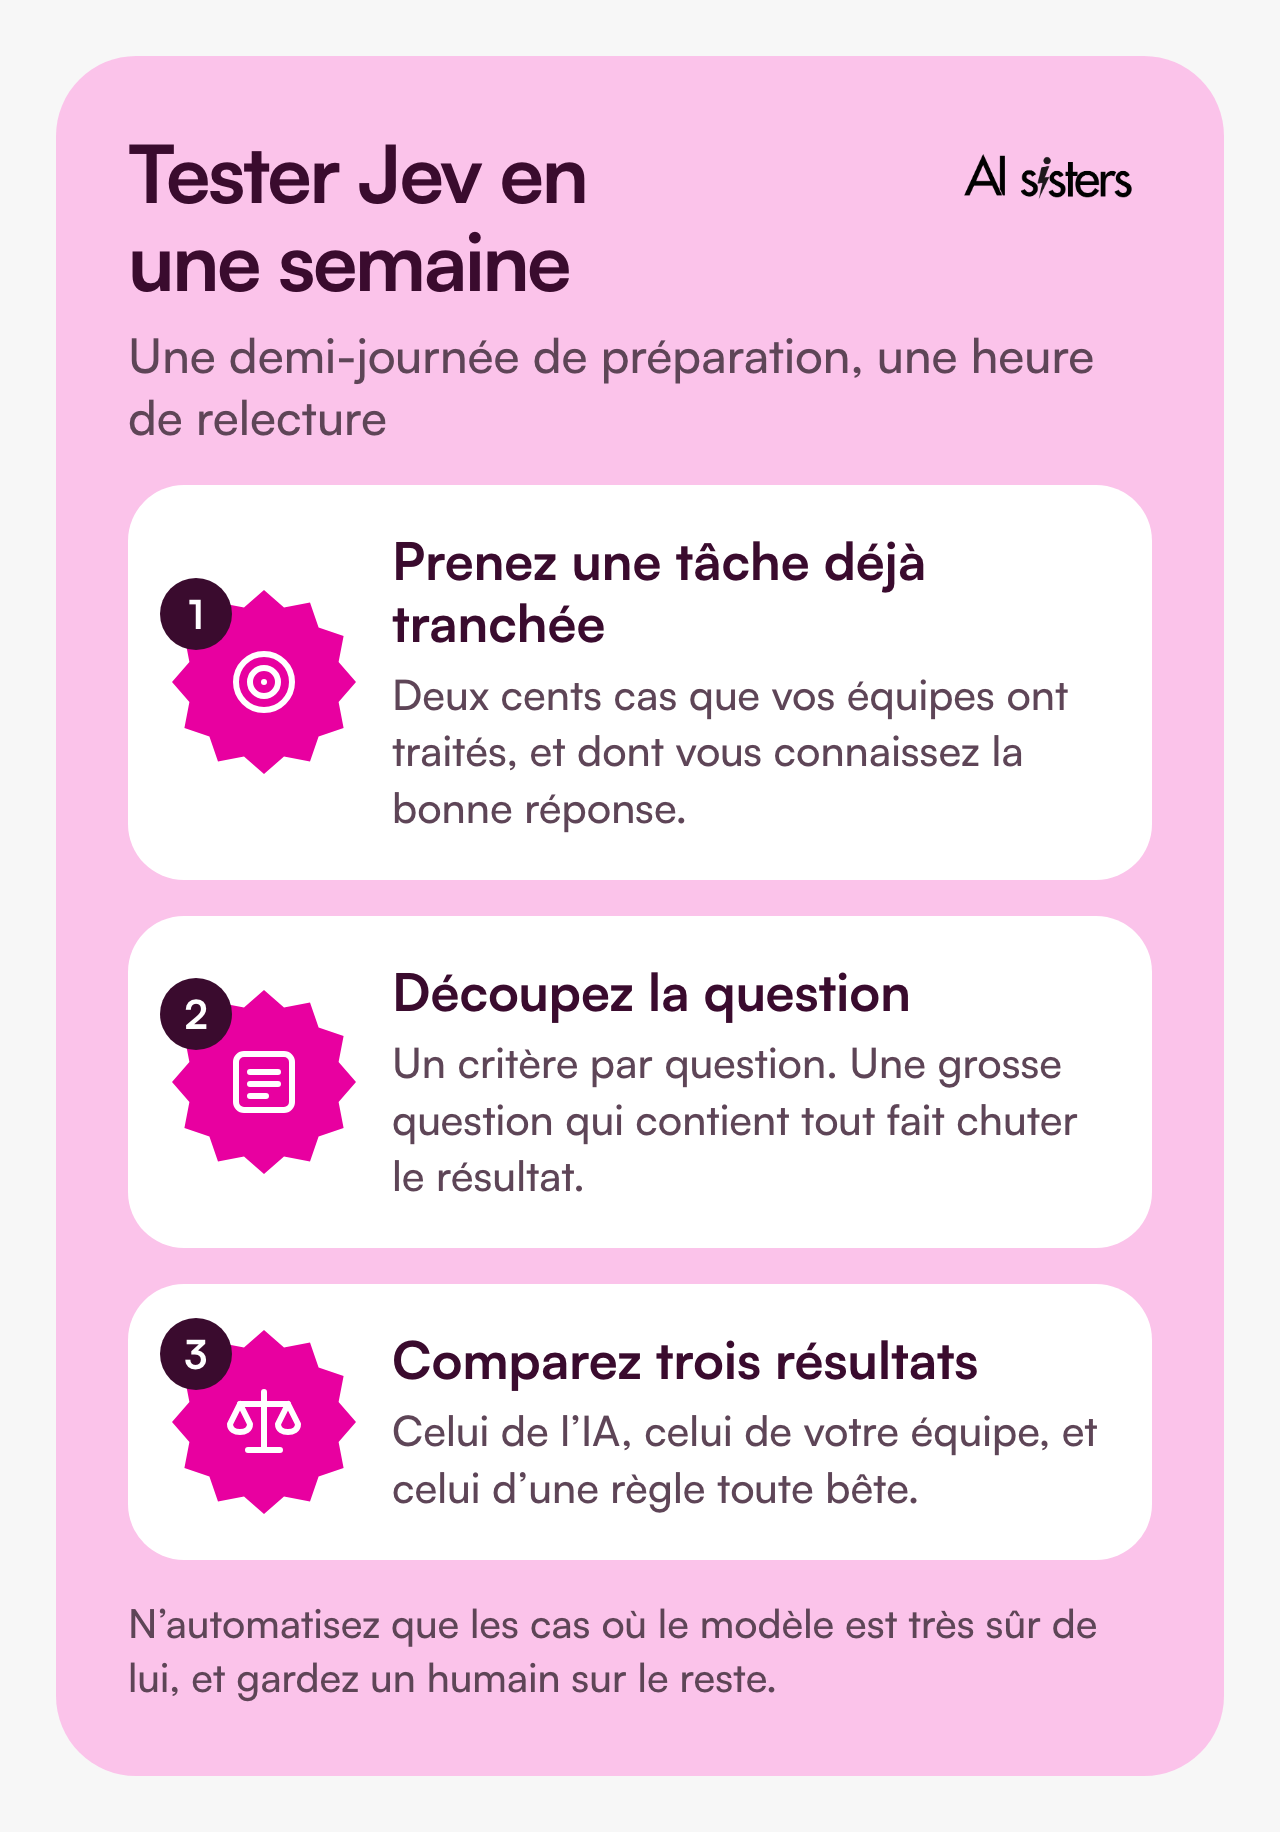
1. Choisissez une tâche de tri qui revient chaque semaine et dont vous connaissez déjà la bonne réponse. Les e-mails entrants, les tickets, les candidatures.
2. Sortez un échantillon déjà traité par vos équipes. Deux cents cas suffisent, à condition qu’ils ressemblent à votre quotidien.
3. Découpez votre question en questions simples. Une par critère, jamais une grosse question qui contient tout.
4. Comparez trois résultats : celui de l’IA, celui de votre équipe, et celui d’une règle toute bête. Vous verrez tout de suite si le modèle apporte quelque chose.
5. Regardez les scores de confiance. N’automatisez que les cas où le modèle est très sûr, et gardez un humain sur le reste.
Comptez une demi-journée de préparation et une heure de relecture. Et si vous voulez brancher ce genre de tri dans un outil qui tourne tout seul, on a écrit un guide complet pour créer un agent IA.
Un mot sur l’accès : Jev est encore en accès anticipé. On y entre par la liste d’attente de l’éditeur, ou par les plateformes qui revendent l’accès aux modèles, comme Vercel et OpenRouter.
Réservez dès maintenant votre appel de 30 minutes
Un échange sans engagement pour construire votre formation IA autour de vos outils.
👉 Parlez-nous de votre projet IA 👈
À retenir
- Jev décide, il ne rédige pas. C’est une nouvelle catégorie d’outil, pas un concurrent de votre assistant.
- Ses cas d’usage, c’est le tri en gros volume : e-mails, commentaires, tickets, documents.
- Les gains de vitesse et de prix sont crédibles, mais mesurés par l’éditeur, sur ses propres tests.
- Aucun organisme indépendant ne l’a évalué. La justesse est à vérifier chez vous.
- Le résultat dépend surtout du découpage de vos questions.
- Avant d’y aller : regardez l’hébergement des données et gardez un humain sur les cas incertains.
Sources
- TypeSafe AI, annonce de Jev et des System One Models, 15 septembre 2026.
- TypeSafe AI, documentation des modèles et page des faiblesses connues.
- TypeSafe AI, politique de confidentialité et accord de traitement des données.
- TypeSafe AI, méthode des évaluations maison.
- The Register, TypeSafe AI debuts model for machines, 16 septembre 2026.
- TechCrunch, a new kind of AI model is thrilling developers, 18 septembre 2026.
- VentureBeat, une façon moins chère de décider, 28 septembre 2026, et l’injection de prompt, 21 septembre 2026.
- LeMagIT, Jev, le modèle de décision pensé pour accélérer l’IA agentique, 24 septembre 2026.
- Blog du Modérateur, Jev, un nouveau modèle d’IA conçu pour prendre des décisions, 23 septembre 2026.
- MindStudio, cas d’usage de Jev, 20 septembre 2026.
- PriorBench, évaluation indépendante préenregistrée, 20 septembre 2026.
- Tarif public relevé chez OpenRouter, 29 septembre 2026.