Google a présenté Gemini 4 Argon, son nouveau modèle d’intelligence artificielle, le 30 septembre 2026. Il est d’abord réservé aux organisations du programme Fairwind, des cyberdéfenseurs sélectionnés par Google. Pour les autres, aucune date.
Vous avez peut-être lu que Google venait de reprendre la tête. C’est vrai sur certains tests, faux sur d’autres, et sans effet immédiat pour vous : hors du programme Fairwind, personne ne peut encore y toucher. Argon arrive aussi après un faux départ : la version 3.5 Pro, annoncée en mai, n’est jamais sortie. Le cabinet SemiAnalysis la dit abandonnée, Google dément. 😅
Ce qui mérite votre attention, ce n’est pas le classement. C’est ce que Google dit viser, et qui est inhabituellement précis : l’ingénierie logicielle, le juridique, la finance et la cyberdéfense.
Chez AI Sisters, on forme les équipes de ces quatre métiers, et on regarde ce que les évaluateurs indépendants mesurent avant de croire un communiqué. C’est parti 👇
Argon « offre des performances de pointe sur des processus complexes : l’ingénierie logicielle réelle, le travail de connaissance en entreprise comme le juridique et la finance, et la cyberdéfense », écrit Google le jour de l’annonce (traduit de l’anglais).
En bref
- Annoncé le 30 septembre, réservé aux cyberdéfenseurs du programme Fairwind. Aucune date pour les autres.
- Il arrive après un faux départ : la version 3.5 Pro, annoncée en mai, n’est jamais sortie. SemiAnalysis la dit abandonnée, Google dément.
- Google nomme quatre domaines : ingénierie logicielle, juridique, finance, cyberdéfense.
- Les évaluateurs indépendants ne disent pas la même chose : premier chez Vals AI et sur Arena.ai, à égalité avec GPT-6 Astra chez Artificial Analysis, derrière Claude Opus 5.5 et Claude Sonnet 5.5.
- Il invente moins, mais il sait moins : quand il ne connaît pas la réponse, il le dit au lieu d’inventer dans 85 % des cas, contre 49 % pour GPT-6 Astra. Mais il trouve la bonne réponse moins souvent : 50 % contre 63 %.
- Il consomme 2,3 fois plus de jetons que GPT-6 Astra pour une même tâche. Moins cher au tarif de lancement, il deviendra plus cher quand ce tarif doublera.
À lire également
Découvrez nos autres articles pour aller plus loin sur le choix de vos outils IA :
Ce que Google annonce, et ce qu’il ne dit pas
Argon est présenté par Koray Kavukcuoglu, vice-président de Google DeepMind et architecte en chef de l’IA de Google, comme un modèle fait pour les travaux qui durent. Pas pour répondre vite, pour tenir un dossier jusqu’au bout.
🔥 Un million de jetons en sortie. La limite de ce que le modèle peut produire en une seule réponse passe de 64 000 à 1 million de jetons, soit de l’ordre de 700 000 mots. Personne n’écrit un rapport de cette taille : l’intérêt est ailleurs. Le modèle peut mener une longue tâche, comme réécrire un gros volume de code, sans la découper en morceaux.
💡 Pour comprendre : un jeton. C’est l’unité que ces modèles découpent, comptent et facturent. Un jeton vaut à peu près un mot court, ou un morceau de mot long : comptez de l’ordre de 700 mots de français pour 1 000 jetons. Tout y passe, ce que vous envoyez comme ce que le modèle vous rend, et c’est pour ça que ces offres se facturent au jeton et pas à la question posée.
🔥 Un prix d’appel, puis le double. 2 dollars le million de jetons en entrée et 10 en sortie pendant le lancement, 4 et 20 ensuite. Les jetons déjà lus et gardés en mémoire tampon, autrement dit ceux d’un document que vous renvoyez plusieurs fois, sont facturés 95 % moins cher.
🔥 Un accès filtré. Le modèle part d’abord aux organisations du programme Fairwind, ouvert le 2 septembre et qui en réunit plus de 650. Ce programme vise les administrations et autorités de cybersécurité, les opérateurs d’infrastructures critiques (santé, énergie, télécoms, finance) et les grandes plateformes technologiques. Ces organisations reçoivent Argon avec ses garde-fous cyber désactivés, en échange de règles strictes sur qui l’utilise et comment chaque usage est enregistré.
⚠️ Et c’est là que l’annonce s’arrête. Google écrit que le modèle arrivera « dès que possible » aux clients payants de l’API, le canal technique par lequel un logiciel appelle le modèle, et aux abonnés Google AI Ultra, puis à tout le monde. Aucune de ces deux étapes n’est datée.
💡 En clair : tant que l’accès reste réservé à Fairwind, personne d’autre ne peut éprouver Argon sur ses propres documents. Un modèle qu’on ne peut pas essayer ne se compare pas, il se croit sur parole.
Les chiffres, et surtout qui les a mesurés
C’est ici que les titres de presse se séparent de la réalité. Une partie des résultats vient de Google, l’autre d’évaluateurs indépendants, et les deux ne racontent pas la même histoire.
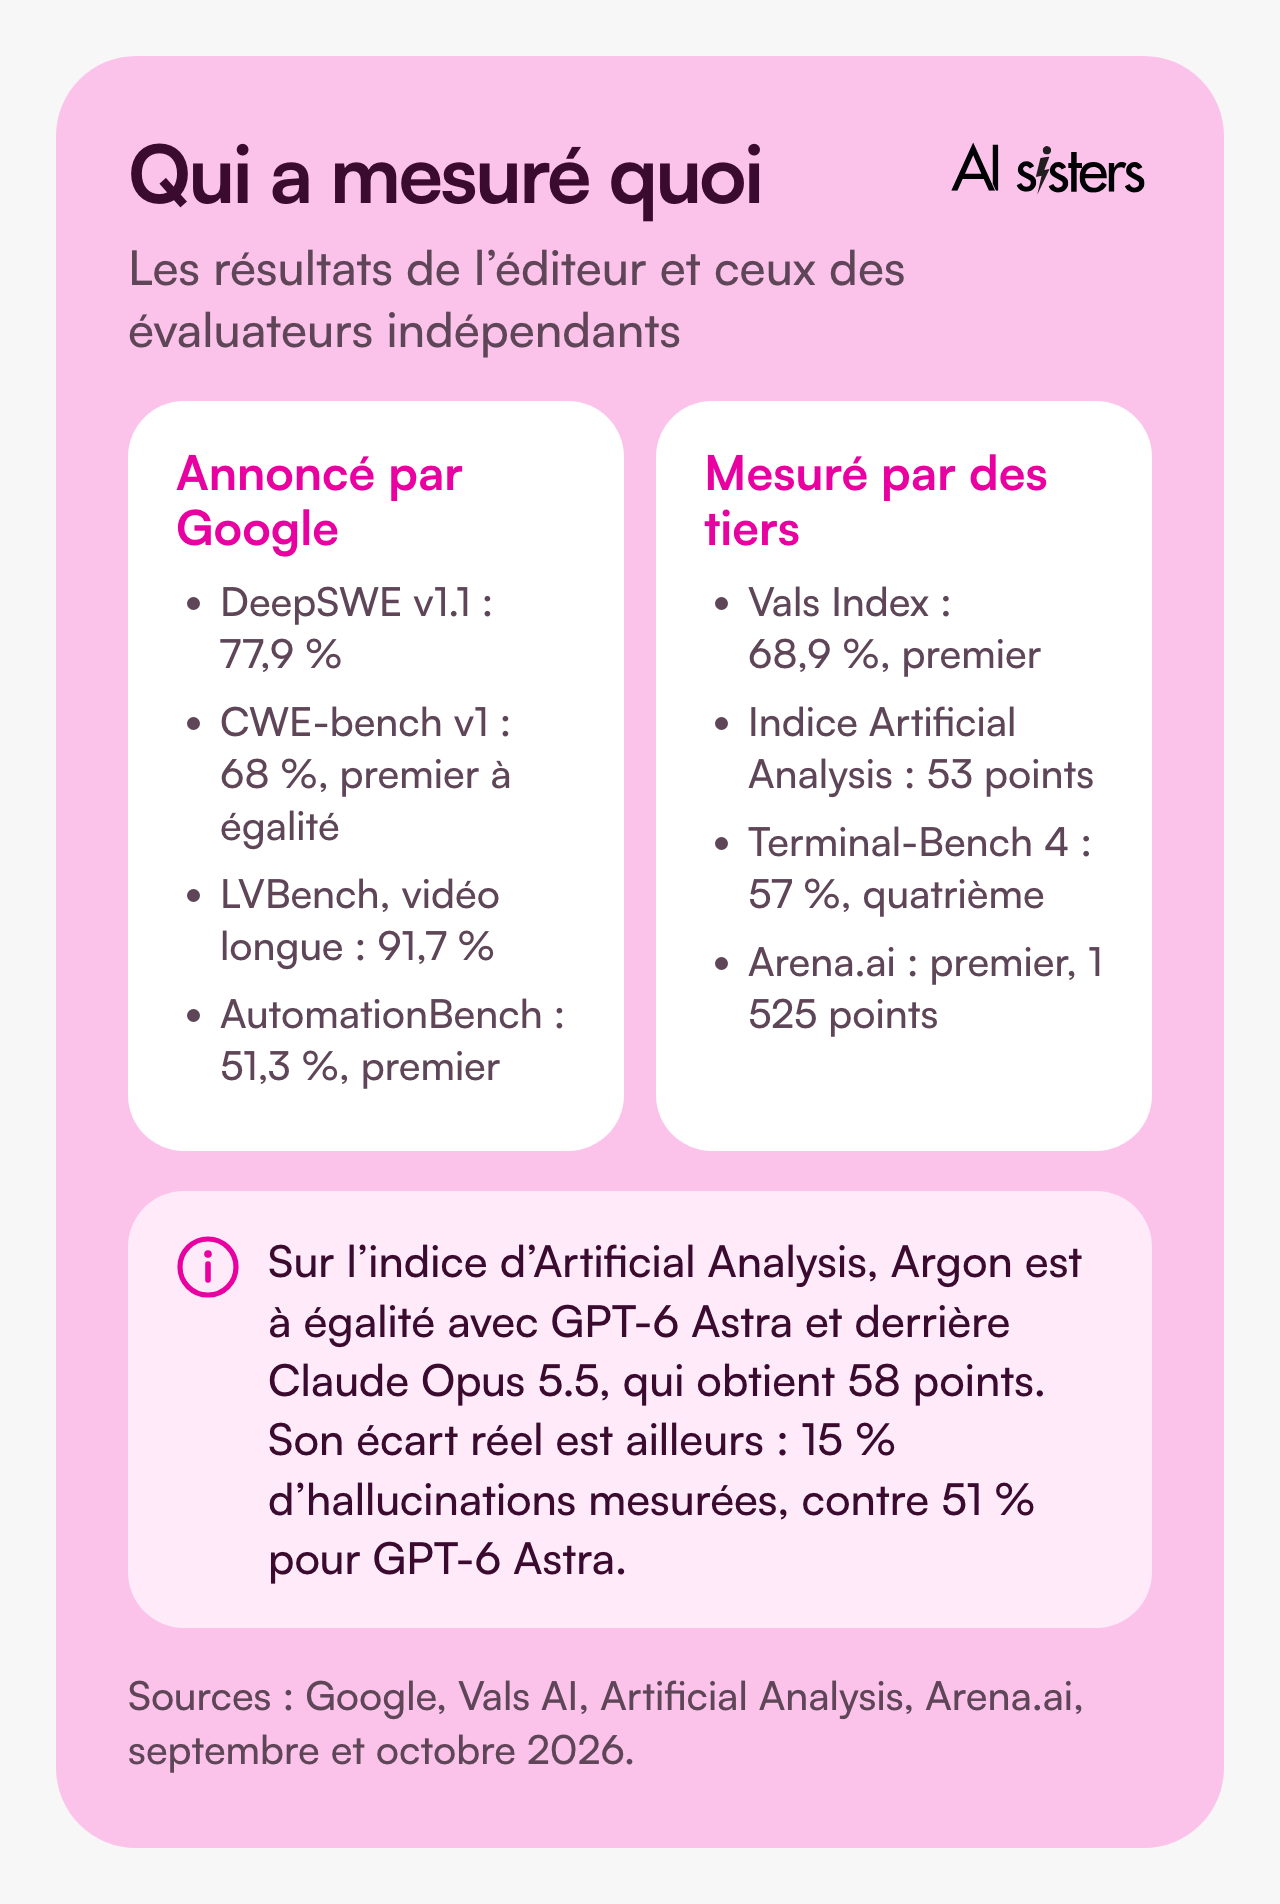
✅ Là où il prend vraiment la tête. Le Vals Index le place premier, à 68,9 %. Ce classement compte parce qu’il vient de Vals AI, un évaluateur indépendant qui construit ses épreuves avec des juristes, des analystes financiers et des ingénieurs en exercice, et qui pondère les domaines selon leur poids réel dans l’économie. Sur Arena.ai, qui mesure la préférence de vraies personnes, Argon arrive aussi premier en texte, avec un classement encore provisoire (moins de 5 000 votes). Il n’est que huitième en développement web.
⚠️ Là où il ne prend pas la tête. Artificial Analysis lui donne 53 points sur son indice d’intelligence, à égalité avec GPT-6 Astra et Claude Fable 5.1, derrière Claude Sonnet 5.5 à 56 et Claude Opus 5.5 à 58. Sur Terminal-Bench 4, qui mesure le travail réel en ligne de commande, c’est-à-dire le pilotage d’une machine en tapant des instructions une par une, il est quatrième à 57 %, derrière Claude Sonnet 5.5 (64 %), Claude Opus 5.5 (60 %) et GPT-6 Astra (59 %).
⚠️ Attention aux noms identiques. Google annonce 51,3 % sur AutomationBench. Artificial Analysis mesure 78 % sur sa propre variante du même test. Deux épreuves différentes derrière un seul nom : si on vous présente un chiffre, demandez laquelle.
⚠️ Le chiffre des hallucinations se lit avec son mode d’emploi. Artificial Analysis pose à chaque modèle des questions de connaissances factuelles (épreuve AA-Omniscience). Quand le modèle ne trouve pas la bonne réponse, il peut dire qu’il ne sait pas, ou halluciner : énoncer une affirmation fausse avec le même aplomb qu’une vraie. Le taux d’hallucination, c’est la part d’inventions dans ce cas-là : 15 % pour Argon, 51 % pour GPT-6 Astra, 54 % pour GPT-6.1 Sol. Argon sait mieux s’abstenir. Mais il trouve aussi moins souvent la bonne réponse : 50 % des questions, contre 63 % pour GPT-6 Astra. Plus sûr à relire, pas plus savant.
💡 Pour comprendre. Un test de modèle, c’est un examen. Le même élève n’a pas la même note selon qui écrit le sujet, qui corrige, et ce qu’on autorise pendant l’épreuve. Quand l’éditeur rédige et corrige lui-même, la note reste une information, mais ce n’est plus une évaluation.
Découvrez nos formations IA & réservez un appel
Explorez nos différents modules de formation et choisissez, avec nous, celui qui répondra le mieux à vos besoins en IA.
📚 Voir nos formations IA 📞 Réserver un appel découverte
Le détail qui décidera de votre facture
Le prix affiché au million de jetons ne dit presque rien de ce que vous paierez. Ce qui compte, c’est combien de jetons le modèle consomme pour faire le travail.
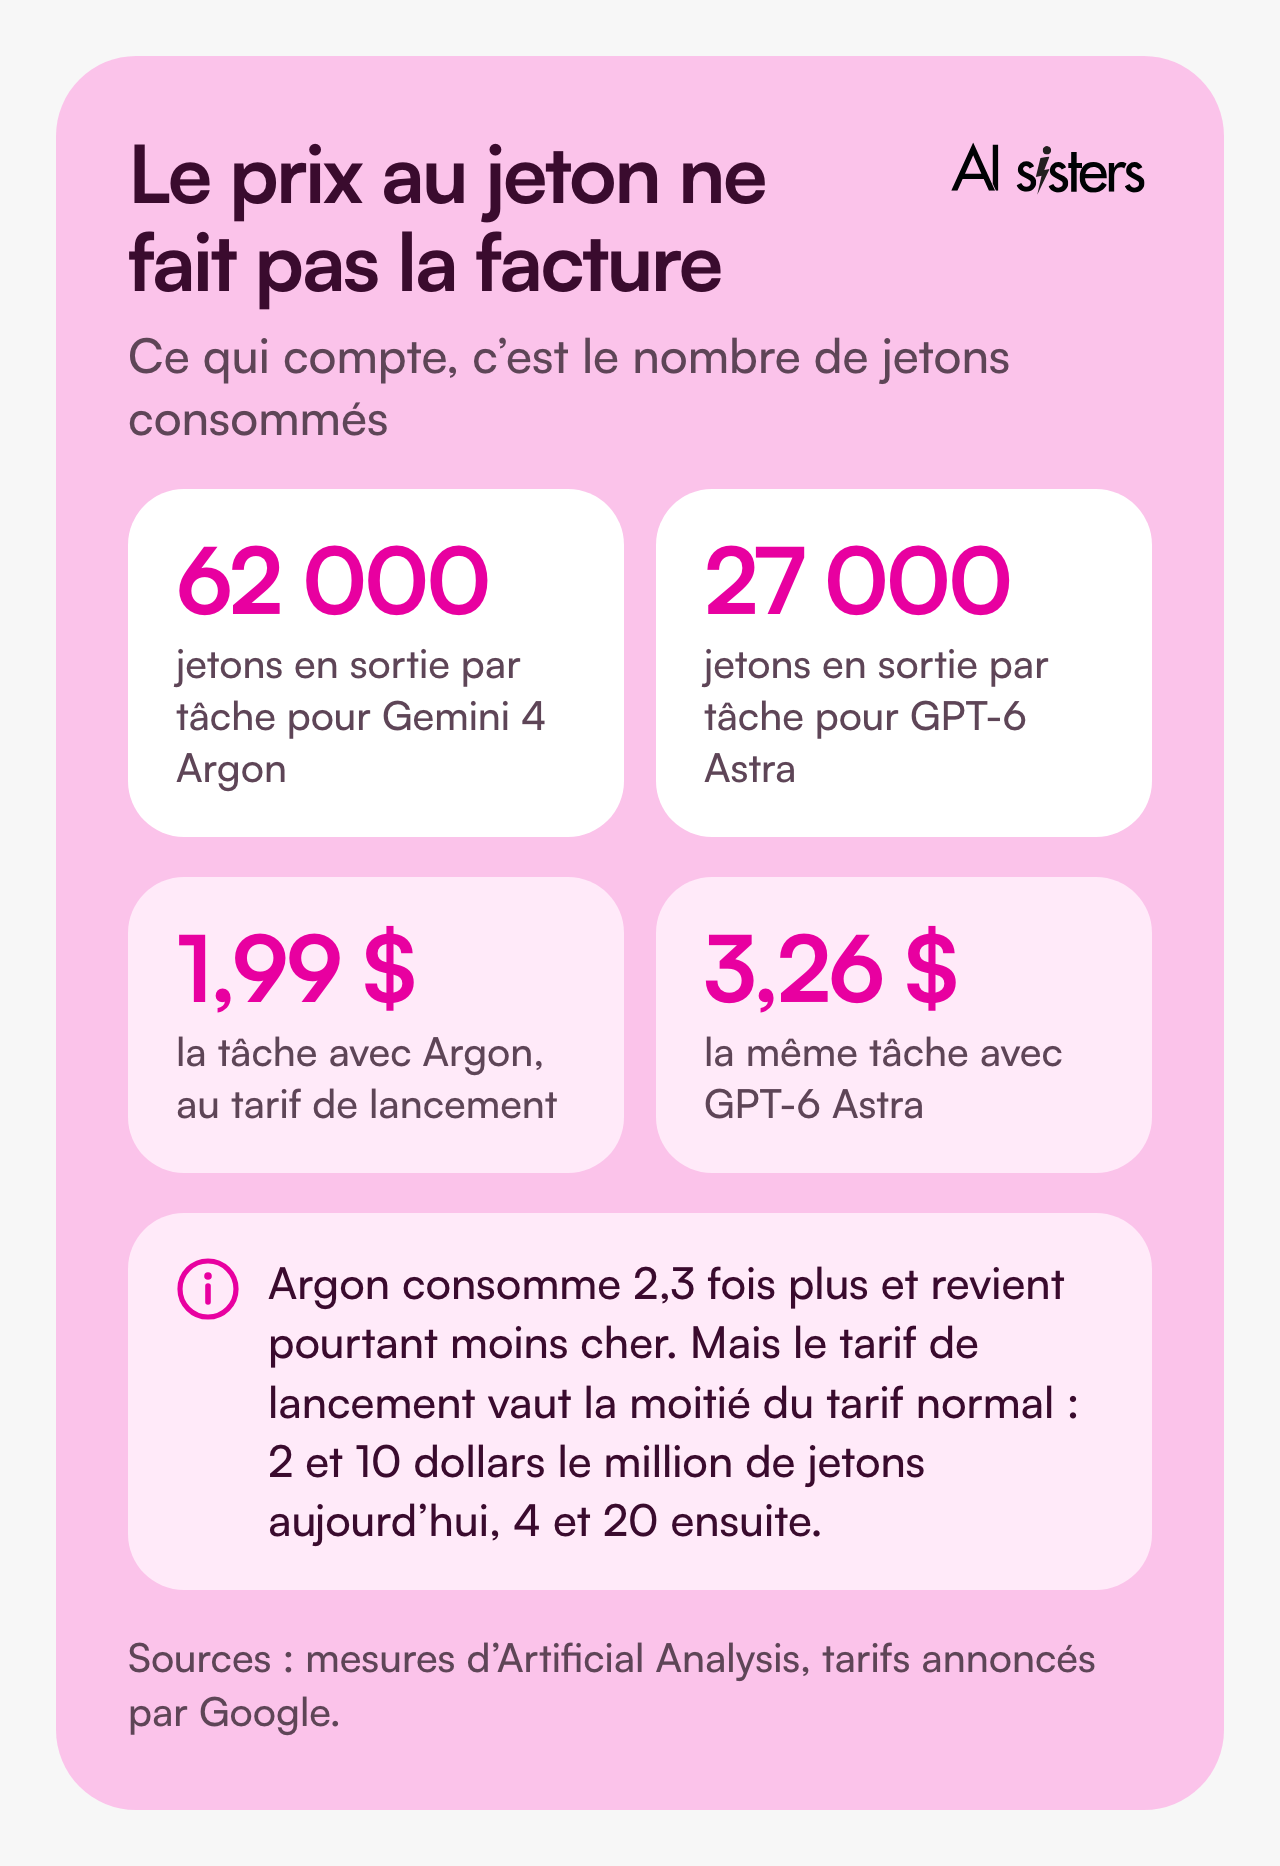
Artificial Analysis a mesuré la consommation sur les épreuves de son indice. Argon produit en moyenne 62 000 jetons en sortie par tâche, contre 27 000 pour GPT-6 Astra. Il réfléchit à voix haute, longuement, et facture chaque mot de cette réflexion.
✅ Le calcul reste à son avantage. Au tarif de lancement, une tâche de cet indice revient en moyenne à 1,99 dollar avec Argon et à 3,26 dollars avec GPT-6 Astra. Son prix au jeton compense largement sa consommation.
⚠️ Mais ce tarif est la moitié du tarif normal. Au prix normal, la même tâche passera à environ 3,98 dollars : plus cher que GPT-6 Astra, à 3,26 dollars. L’avantage de prix d’Argon ne dure que le temps du lancement. Un modèle bavard sur un prix doublé, c’est le poste de dépense à surveiller, surtout si vous le branchez sur un traitement automatique qui tourne toute la journée.
💡 En clair : le prix au million de jetons, c’est le prix affiché à la pompe. Votre facture, c’est le nombre de kilomètres, multiplié par la consommation réelle du véhicule. Deux modèles au même tarif peuvent coûter du simple au double sur une année.
Ce que ça pourrait changer pour quatre métiers
Google nomme quatre domaines. Voici, pour chacun, ce que les mesures disent vraiment et par quoi commencer le jour où le modèle sera accessible. Le conditionnel est volontaire : rien de tout cela n’est testable aujourd’hui hors Fairwind.

Pour une équipe de développement : les migrations, pas les démonstrations.
Google dit avoir migré plus de 800 000 lignes de code en interne avec Argon, et affiche 77,9 % sur DeepSWE. Mais Terminal-Bench 4, qui mesure le travail réel en ligne de commande, le place quatrième. Lisez ces deux chiffres ensemble : fort sur les transformations de code en volume, pas en tête sur la conduite d’un poste de travail. Première tâche à confier : une montée de version de bibliothèque sur un dépôt de code secondaire, relue par une personne avant d’être intégrée.
Pour une équipe juridique : la revue, pas la rédaction finale.
Le Vals Index, où Argon est premier, mélange plusieurs domaines : son classement général ne dit pas à lui seul ce que vaut le modèle en droit. Le signal juridique le plus net vient de Harvey, éditeur d’un assistant pour avocats : selon les chiffres publiés par Google, Argon obtient 19,6 % sur son épreuve d’agent juridique, contre 6,7 % pour le modèle suivant. Le score reste bas, ce qui dit surtout que ces tâches résistent encore à toutes les IA. Première tâche à confier : la revue de conformité d’un contrat type que vous connaissez par cœur, pour comparer sa sortie à ce que vous auriez écrit. Point de vigilance : un contrat envoyé à une API sort de l’entreprise, et c’est une décision qui se prend avant le test, pas après.
Pour une équipe finance : le chiffre vérifié, pas le chiffre plausible.
Les épreuves financières de Vals AI demandent d’extraire des données d’un contrat de crédit, de les croiser entre sociétés comparables et de produire une recommandation sans inventer de montant. C’est là que la prudence d’Argon compte : un modèle qui répond « je ne sais pas » au lieu d’inventer un montant fait gagner du temps de vérification. Mais Argon ne trouve la bonne réponse que dans la moitié des cas sur l’épreuve d’Artificial Analysis : il ne dispense d’aucune vérification. Première tâche à confier : la synthèse d’un rapport annuel déjà analysé par vos soins, pour vérifier chaque chiffre un par un.
Pour une équipe sécurité : le seul métier servi aujourd’hui.
Argon obtient 68 % sur CWE-bench v1, un test de correction de vulnérabilités, et l’éditeur Wiz l’utilise déjà dans son initiative Scan for Good. C’est aussi le seul métier qui y a accès, via Fairwind, et avec les garde-fous cyber levés. Si votre organisation n’est pas dans ce programme, il n’y a rien à tester : Google vérifie chaque organisation avant de l’admettre, et la page du programme en détaille les conditions.
Réservez dès maintenant votre appel de 30 minutes
Un échange sans engagement pour construire votre formation IA autour de vos outils.
👉 Parlez-nous de votre projet IA 👈
Ce que vous pouvez faire avant qu’il arrive
Un modèle annoncé n’est pas un modèle déployé. Voici le travail qui se fait pendant l’attente, et qui ne sera pas perdu si Argon déçoit.

Ne réécrivez pas votre feuille de route. Un modèle qu’on ne peut pas acheter ne change aucun arbitrage. Les annonces de rentrée se suivent vite, et les équipes qui changent de cap à chacune ne déploient jamais rien.
Préparez votre propre épreuve. Rassemblez dix tâches réelles de votre métier dont vous connaissez déjà la bonne réponse : un contrat dont vous avez la revue, un rapport dont vous avez la synthèse, un bogue dont vous avez le correctif. Le jour où Argon sera disponible, vous aurez une mesure en une demi-journée au lieu d’une impression.
Regardez le poste sortie, pas le prix affiché. Sur les modèles que vous utilisez déjà, sortez la consommation moyenne en jetons par tâche. C’est la seule base qui vous permettra de comparer honnêtement une offre à une autre, et notre panorama des outils IA détaille ce calcul pour les abonnements courants.
Tranchez la question des données avant le test. Contrats, rapports financiers, code propriétaire : décidez ce qui a le droit de sortir, et écrivez-le. La CNIL a publié des fiches pratiques pour cadrer ces usages dans les TPE et PME, et une règle écrite une fois sert pour tous les outils suivants.
Formez sur ce qui est déjà là. Savoir cadrer une tâche, vérifier une sortie et repérer une invention se transfère d’un modèle à l’autre. C’est tout le principe de notre approche de la formation par métier, et si vous partez de zéro, on a écrit un guide concret pour intégrer l’IA dans une entreprise.
Réservez dès maintenant votre appel de 30 minutes
Un échange sans engagement pour construire votre formation IA autour de vos outils.
👉 Parlez-nous de votre projet IA 👈
À retenir
- Argon est annoncé, pas disponible : réservé aux cyberdéfenseurs de Fairwind, sans date pour la suite.
- Il arrive après une version 3.5 Pro jamais publiée (abandonnée selon SemiAnalysis, toujours en développement selon Google), ce qui invite à attendre la disponibilité réelle plutôt que l’annonce.
- Premier chez Vals AI et sur Arena.ai, à égalité avec GPT-6 Astra chez Artificial Analysis, derrière Claude Opus 5.5 et Claude Sonnet 5.5.
- Il invente moins quand il ne sait pas : 15 % d’hallucinations contre 51 % pour GPT-6 Astra, mais 50 % de bonnes réponses contre 63 %.
- Il est bavard : 62 000 jetons en sortie par tâche contre 27 000. Moins cher au lancement, il passera devant GPT-6 Astra en coût quand le tarif doublera.
- Le travail utile se fait maintenant : votre épreuve maison, votre règle sur les données, la formation de vos équipes.
Sources
- Google, Gemini 4 Argon: our next era of frontier intelligence, 30 septembre 2026.
- OfficeChai, Google has silently canceled Gemini 3.5 Pro, says SemiAnalysis report, 10 août 2026.
- The Decoder, Gemini 4 Argon closes the gap with OpenAI and Anthropic but doesn’t take a clear lead, 1er octobre 2026, reprenant les mesures d’Artificial Analysis.
- Artificial Analysis, Gemini 4 Argon: Google is back as one of the top three labs in intelligence achieved, 30 septembre 2026.
- Google, Proactive cyber defense for governments and enterprises (programme Fairwind), 2 septembre 2026.
- Vals AI, Vals Index, consulté le 8 octobre 2026.
- TechCrunch, Google releases Gemini 4 Argon, called its most powerful model yet, 30 septembre 2026.
- CNIL, utiliser l’IA générative dans les TPE et PME, consulté le 8 octobre 2026.